
AI Agent 生产环境漂移检测:长期保持性能的实用指南
引言
部署在生产环境中的 AI Agent 面临一个持续存在的挑战:随着周围世界的变化,其性能会随时间下降。这种现象被称为漂移(drift),它会悄无声息地侵蚀 Agent 的可靠性,而不会触发明显的故障。理解漂移检测对于维护生产环境 AI 系统至关重要。
漂移以多种形式出现。输入数据可能因用户行为演变或外部条件变化而发生偏移。微调引入意外副作用时,或模型对语言模式的理解与实际使用情况产生偏差时,模型行为也可能漂移。当第三方 API 更新其接口或返回码时,工具输出可能变得不可靠。
本指南为在生产环境 AI Agent 系统中实施漂移检测提供了实用框架。我们将涵盖漂移在实际中的表现、如何系统性地衡量漂移,以及在检测到异常时应采取的措施。
什么是 AI Agent 漂移?
漂移指部署后出现的任何偏离预期行为的现象。与传统软件 bug 不同,漂移是渐进式的,往往很微妙。Agent 仍然能够运行,但其输出的可靠性、相关性或与当前需求的对齐程度逐渐下降。
在 AI Agent 的上下文中,漂移影响系统架构的多个层次。在输入层,用户查询可能在语气、复杂度或领域重点上发生变化。在模型层,底层语言模型可能生成具有不同质量特征的回答。在工具层,外部 API 可能改变其响应格式或行为模式。
未被检测到的漂移后果会随时间累积。微小的性能退化不断叠加,最终导致严重的可靠性问题。用户会注意到响应变慢、信息错误或工具选择不当。在生产环境中,这些问题直接影响业务成果和用户信任。
AI Agent 系统中的漂移类型
输入漂移
输入漂移发生在查询或提示的分布随时间变化的情况。用户行为不断变化,新的用例不断涌现,语言模式也会演变。接受正式商务查询训练的 Agent 在用户开始提出随意性问题时可能会遇到困难。同样,领域特定的 Agent 在用户引入训练覆盖范围之外的主题时可能会失效。
输入漂移的常见指标包括完成率下降、澄清请求增加,以及特定查询类型的错误率升高。监控输入分布有助于识别 Agent 的训练数据是否已不能代表当前的使用模式。
模型漂移
模型漂移影响 AI 生成回答的质量和一致性。即使不进行重新训练,语言模型也可能因温度参数变化、上下文窗口效应,或模型对指令理解方式的微妙变化而表现出不同的行为模式。当提示词更新或系统指令发生变化时,模型的响应分布也会相应偏移。
模型漂移尤其具有挑战性,因为它不会产生明显的错误。回答依然连贯且语法正确,但其质量、相关性或与用户意图的对齐程度可能逐渐退化。
工具和集成漂移
工具漂移发生在外部依赖项改变行为时。API 更新其端点、返回码或响应格式。认证方法不断更新。速率限制发生变化。第三方服务可能废弃某些功能或更改定价模式。
对于严重依赖外部工具的 AI Agent,集成漂移是生产故障的主要来源。一个在测试中完美运行的工具,由于超出你控制范围的变更,可能在实际生产中表现出不同的行为。
数据与知识漂移
知识漂移影响依赖外部知识库或数据库的 Agent。随着信息发生变化,缓存或检索的内容变得过时。产品价格更新、文档迁移、事实信息过时。返回过期信息的 Agent 即使其核心逻辑正确,也会显得不可靠。
衡量漂移:关键指标
质量评分跟踪
对 Agent 输出实施多维度质量评分。常用指标包括回答相关性、准确性、完整性以及与用户意图的对齐程度。使用自动化评估与人工评审相结合的方法建立基准分数,然后跟踪随时间的偏离情况。
质量评分应集成到 Agent 的输出流水线中。每个回答都会根据既定标准进行评估,并连同元数据一起记录日志以供趋势分析。当质量分数低于阈值时,系统会触发警报进行调查。
置信度与确定性指标
监控模型对其预测和决策的置信度水平。置信度的突然下降可能表明模型正在遇到不熟悉的模式或训练分布之外的输入。跟踪置信度分布随时间的变化,以识别渐进式偏移。
置信度指标对于检测模型正在挣扎但未完全失败的边缘情况特别有用。这些临界案例往往代表漂移的早期预警信号。
用户反馈信号
用户交互提供了关于 Agent 性能的大量反馈信号。跟踪接受率、纠正频率、后续问题和明确反馈等指标。接受率下降或纠正频率增加通常表明在其他指标变得明显之前就已出现漂移。
实施轻量级反馈机制,避免干扰用户体验。简单的点赞/点踩、相关性评分,甚至分析用户是否接受建议的操作,都能提供有价值的信号。
延迟与资源消耗
监控延迟模式和资源消耗。当 Agent 遇到需要更多计算的不熟悉模式时,漂移可能表现为处理时间增加。Token 使用量或 API 调用量的异常激增可能表明 Agent 正在应对变化的输入或退化的工具响应。
实施漂移检测
建立基线
在检测漂移之前,你需要建立基线。让 Agent 在生产环境中运行一段时间,收集所有相关维度的指标。记录质量分数、延迟、置信度水平和用户反馈指标的正常运行范围。
基线建立应涵盖不同的运行条件。在各种负载水平、高峰时段和不同用户群体中收集数据。这创建一个全面的基线,考虑生产环境中正常的波动。
统计过程控制
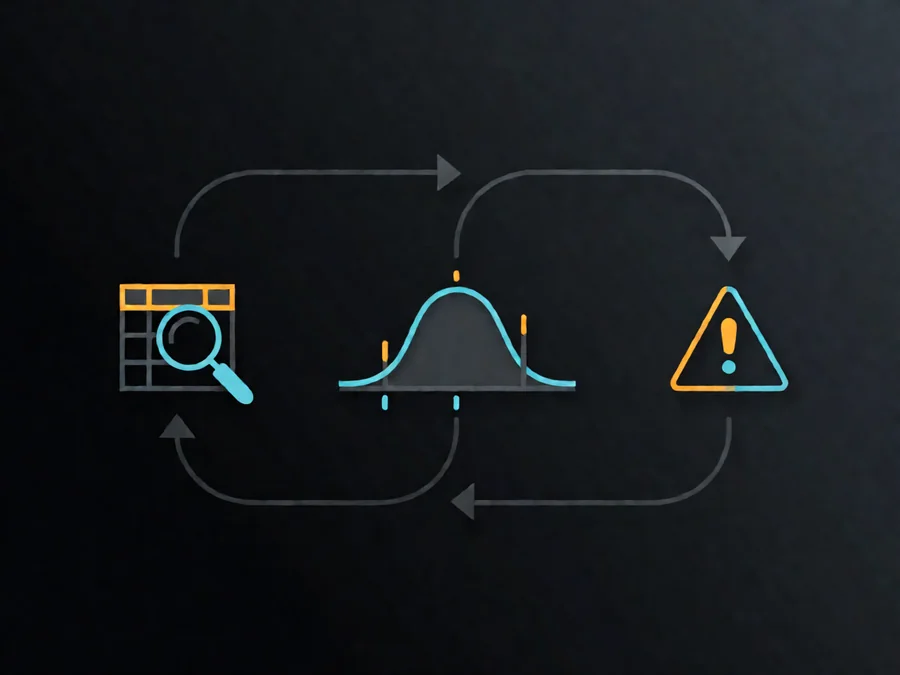
应用统计过程控制技术来监控关键指标随时间的变化。使用控制图可视化指标趋势,识别超出预期范围的值。移动平均、指数平滑和标准差跟踪等技术有助于区分正常波动与有意义的漂移。
控制图应随新数据的到来持续更新。当指标超出控制限或显示持续的单方向趋势时,系统应将其标记为潜在漂移指标。
变更的 A/B 测试
当对 Agent 系统进行变更——无论是更新提示词、修改工具集成还是调整参数——使用 A/B 测试检测这些变更引起的漂移。将修改后的版本与当前版本并行运行,比较关键指标以确定变更是否改善或降低了性能。
A/B 测试为评估变更提供了受控条件。即使微小的性能差异,在数千次交互的衡量下也变得有意义,有助于发现手动审查可能错过的细微漂移。
自动告警
设置当指标超出定义阈值或显示持续趋势时的自动告警。告警应可操作,提供足够的调查上下文。包括最近的指标值、趋势信息和指向相关日志或仪表盘的链接。
告警阈值应经过校准,以避免过多误报和漏报。过多的误报会导致告警疲劳;过少的告报则会让漂移在无察觉的情况下继续发展。定期根据观察到的模式和调查结果审查和调整阈值。
应对检测到的漂移
根本原因分析
检测到漂移后,进行系统性的根本原因分析。检查系统的近期变更,包括提示词、工具、集成或部署配置的更新。审查输入分布,识别用户行为或查询模式的变化。分析错误模式和故障点,定位具体的失败位置。
根本原因分析应涉及多方利益相关者。理解系统架构的工程师、了解用户期望的产品经理,以及能够解读指标趋势的数据分析师,都有助于识别根本原因。
缓解策略
各种缓解策略针对不同类型的漂移。对于输入漂移,考虑基于近期数据重新训练或微调模型。对于工具漂移,更新集成以匹配已变化的 API,或添加备用机制。对于模型漂移,尝试提示词工程、温度调整或替代模型版本。
缓解应逐步实施并持续监控。分阶段部署变更,观察其对关键指标的影响。如果缓解策略未能改善漂移或引入了新问题,则回滚并尝试其他方法。
持续监控
实施持续监控,尽早发现漂移并长期维护系统健康。对关键指标的仪表板可见性帮助团队保持对系统性能的意识。定期对漂移指标和趋势分析的审查有助于指导主动维护决策。
持续监控应成为运营惯例的一部分。在每日站会、每周审查和月度报告中纳入漂移指标。跟踪长期趋势,了解季节性模式、增长效应和系统变更对 Agent 性能的影响。
案例研究
电商支持 Agent
一个电商支持 Agent 在三个月内显示出质量分数持续下降。分析发现,产品品类随着目录扩展而不断变化,但 Agent 的知识库未按比例更新。实施自动化知识库刷新并扩大品类覆盖范围后,质量分数恢复到基线水平。
财务分析助手
一个财务分析 Agent 在市场波动期间经历了延迟和错误率上升。该 Agent 的工具集成依赖的市场数据提供商在高流量期间实施了更严格的速率限制。通过添加缓存、备用数据源和自适应速率限制,解决了波动期间的性能降级问题。
医疗健康信息系统
一个医疗健康信息 Agent 开始返回过时的治疗指南。底层医学知识库每季度更新一次,但临床指南的变更频率更高。实施实时指南更新系统并在回答中添加新鲜度指标,防止了使用过时医学信息的风险。
常见陷阱
忽视渐进式变化
微小、渐进的漂移比突然的故障更难检测。如果没有系统性监控,团队可能要到性能退化变得显著时才会注意到。实施持续监控以尽早发现渐进式变化。
过度依赖自动化指标
虽然自动化指标很有价值,但它们可能遗漏上下文因素。质量分数可能保持稳定,但用户满意度可能因交互风格的微妙变化而下降。将自动化监控与定期用户反馈收集和定性分析相结合。
被动应对而非主动预防
许多团队仅在用户抱怨后才应对漂移。实施主动监控和告警系统,使团队能够在漂移严重影响用户之前解决它。建立阈值和响应流程,实现早期干预。
忽视工具依赖
工具漂移常常被忽视,因为团队专注于其核心 Agent 逻辑。然而,外部依赖可能是性能退化的重大来源。在监控 Agent 性能指标的同时,也要监控工具集成健康状态。
实施清单
- [ ] 定义关键绩效指标并建立基准值
- [ ] 为 Agent 输出实施自动化质量评分
- [ ] 设置用于趋势监控的统计过程控制
- [ ] 配置指标偏差和持续趋势的告警
- [ ] 建立漂移事件的根本原因分析流程
- [ ] 创建针对常见漂移场景的缓解方案
- [ ] 实施持续监控仪表盘
- [ ] 定期审查漂移指标和趋势
- [ ] 记录漂移事件及解决方案
- [ ] 培训团队成员掌握漂移检测与应对流程
结论
漂移检测对于长期维护生产环境 AI Agent 系统至关重要。通过实施系统性监控、建立基线,并对检测到的变更采取主动应对措施,组织可以保持 Agent 的可靠性和性能。关键在于将漂移检测视为持续的运营实践,而不是一次性的设置任务。
定期审查漂移指标,结合用户反馈和系统性偏差调查,形成维护 AI Agent 质量的韧性方法。随着 Agent 系统日益成为业务运营的重要组成部分,检测和分析漂移的能力将成为竞争优势。
常见问题
问:我应该多久检查一次漂移?
答:实施持续监控并设置显著偏差的自动告警。对于关键系统每日审查漂移指标,对于标准运营每周审查,对于长期趋势分析每月审查。
问:漂移和 bug 有什么区别?
答:bug 是逻辑或实现中的离散故障。漂移是由于环境变化导致的性能渐进式退化。bug 通常需要代码修复;漂移通常需要模型更新、重新训练或配置调整。
问:我能否完全防止漂移?
答:在动态环境中完全防止漂移是不可能的。但通过系统性监控和主动响应,可以将漂移对系统性能 and 用户体验的影响降到最低。
问:我如何判断漂移是否严重?
答:根据业务影响、用户反馈和指标退化幅度评估漂移严重程度。小的偏差可能可以接受;持续的趋势或快速退化需要立即调查。
问:哪些工具有助于漂移检测?
答:多种工具支持漂移检测,包括监控平台、统计分析库和自定义指标跟踪系统。选择与现有可观测性栈集成并满足你特定监控需求的工具。
—
准备好为你的 AI Agent 系统实施强大的漂移检测?请访问 SmaugBrain,了解我们内置监控和自动漂移检测功能的全面 Agent 平台。