
AI Agent 错误处理与可观测性:生产环境指南
为什么 AI Agent 需要关注错误处理
与传统软件不同,AI Agent 运行在不可预测的环境中。它们与外部 API 交互、处理模糊的输入,并执行多步骤工作流——任何一步失败都可能产生级联效应。如果没有健壮的错误处理机制,一次简单的 API 超时或格式错误的响应就可能破坏整个工作流,甚至让系统处于不一致的状态。
生产环境的 AI Agent 需要系统化的方法来检测、恢复和监控错误。本指南介绍构建 Agent 的实用策略,使其能够优雅地处理故障,同时保持用于调试和优化的可观测性。
AI Agent 面临的错误类型
理解错误类别有助于设计合适的处理策略:
瞬时故障
暂时性的问题,重试后通常可以恢复:API 速率限制、网络超时、服务降级。这类问题占生产环境错误的 60-80%,应使用指数退避和熔断器来处理。
持久性故障
需要人工干预的系统性问题:认证失败、权限错误、外部 API 的 schema 变更。这类问题需要告警和人工解决路径。
语义错误
Agent 推理或工具选择中的逻辑错误:调用了错误的 API 端点、误解响应内容、生成了无效的工具参数。这类错误需要验证层和输出校验机制。
上下文限制超限
处理大文档或维持长对话时发生的 token 上限超限。这类问题需要通过分块策略和基于摘要的上下文管理来解决。
错误处理模式
| 模式 | 适用场景 | 实现方式 |
|---|---|---|
| 带退避的重试 | 瞬时 API 故障 | 指数退避加随机抖动,最多 3-5 次尝试 |
| 熔断器 | 反复出现的故障 | 超过阈值后熔断,半开状态进行测试 |
| 降级响应 | 关键操作 | 主路径失败时执行备用逻辑 |
| 跳过并继续 | 非关键步骤 | 记录错误,执行下一步 |
| 补偿操作 | 部分完成 | 撤销副作用,恢复状态 |
实现指数退避重试
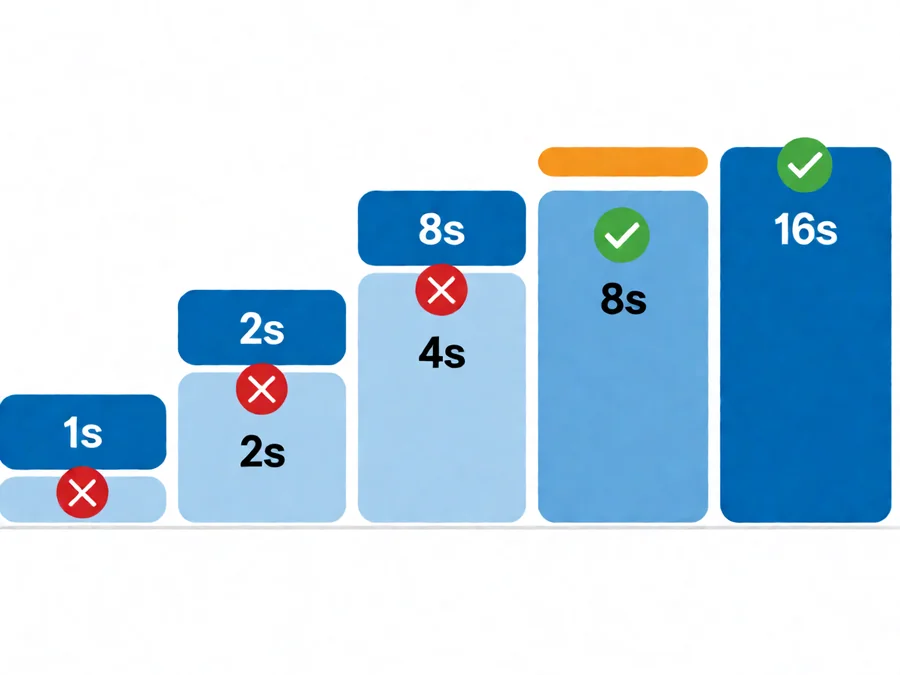
处理瞬时故障最常见的模式。SmaugBrain Agent 自动实现此模式,支持可配置参数:
- 初始延迟:1 秒
- 最大延迟:60 秒
- 退避倍数:2x
- 最大重试次数:3-5 次(可按工具配置)
- 抖动:随机 0-25%,防止惊群效应
示例代码展示了该模式的实现:
for attempt in range(max_retries):
    try:
        result = await call_external_api(payload)
        return result
    except RateLimitError as e:
        if attempt == max_retries - 1:
            raise
        delay = min(initial_delay * (2 ** attempt), max_delay)
        delay *= random.uniform(0.75, 1.0)  # 抖动
        await asyncio.sleep(delay)
    except NetworkTimeout:
        continue  # 立即重试
熔断器实现
当外部服务反复失败时,继续尝试调用会浪费资源,甚至可能触发速率限制。熔断器经历三个阶段:
- 关闭(Closed):正常运行,持续统计失败次数
- 打开(Open):失败次数超过阈值,立即返回失败
- 半开(Half-Open):超时后允许一次测试请求
该模式可防止系统中的级联故障,并为外部服务恢复争取时间。
AI Agent 的可观测性
有效的错误处理需要充分了解 Agent 的行为。可观测性的三大支柱同样适用:
日志
结构化日志记录执行追踪、工具调用、参数值和错误条件。关键原则:
- 按适当级别记录日志(DEBUG、INFO、WARN、ERROR)
- 包含关联 ID 以支持请求追踪
- 避免记录敏感数据(API 密钥、个人身份信息)
- 使用 JSON 格式便于程序化解析
良好的日志实践包括记录导致失败的具体输入、错误信息以及错误发生前系统的状态。
指标
对 Agent 性能和可靠性的量化度量:
- 按工具和操作类型划分的成功率/失败率
- 延迟百分位数(p50、p95、p99)
- 每条执行路径的 token 消耗量
- 速率限制命中频率
- 重试次数及结果
- 故障恢复时间
在实时仪表板中跟踪这些指标,并对异常模式设置告警。
追踪
端到端请求流程可视化,展示所有工具调用、其持续时间和结果。对于调试复杂的多步骤 Agent 工作流至关重要。
追踪有助于回答:哪个工具调用失败了?每个步骤耗时多久?导致错误的具体输入是什么?失败发生在某个决策点之前还是之后?
错误恢复策略
自我纠正循环
当 Agent 检测到错误时,可以通过以下方式尝试恢复:
- 分析错误消息和上下文
- 生成替代方案
- 执行恢复尝试
- 验证结果
这种模式适用于 Agent 有足够上下文进行调整的语义错误。例如,如果搜索 API 返回空结果,Agent 可能会重新构造查询或尝试不同的数据源。
人工介入升级
对于持久性或高严重程度的错误,Agent 应升级到人工操作员:
- 清晰的错误描述及相关上下文
- 推荐的操作方案或替代选项
- 问题解决后的轻松恢复路径
- 已尝试恢复操作的审计记录
升级时应包含所有相关上下文:正在尝试什么操作、什么失败了、已尝试过什么以及有哪些解决选项。
使用 SmaugBrain 的实践实现
SmaugBrain 提供了遵循以下模式的内置错误处理机制:
- 自动重试:可按工具配置,采用指数退避
- 超时强制执行:工具级超时防止挂起
- 错误分类:区分瞬时与永久故障
- 结构化日志:带有执行上下文的 JSON 日志
- 告警集成:针对持久性故障的 Webhook 通知
在您的 SmaugBrain Agent 定义中配置这些设置,以匹配您的可靠性要求。
实施清单
在将 AI Agent 部署到生产环境之前,请确认以下错误处理要求:
| 检查项 | 状态 |
|---|---|
| 已实现带指数退避的重试逻辑 | ☐ |
| 已为外部依赖配置熔断器 | ☐ |
| 已使用关联 ID 配置结构化日志 | ☐ |
| 已配置错误指标仪表板 | ☐ |
| 已定义人工升级路径 | ☐ |
| 已记录恢复流程 | ☐ |
| 已进行故障注入渗透测试 | ☐ |
| 已制定失败部署的回滚策略 | ☐ |
错误处理的常见陷阱
在构建生产环境 AI Agent 时,请避免以下错误:
吞掉错误
静默捕获所有异常会隐藏真正的问题。务必记录足够的上下文以供调试。使用具体的异常类型,而不是裸的 except 子句。
过度重试
对持久性故障进行重试会浪费资源。重试前应区分瞬时故障与永久故障,检查错误是否属于可重试类别。
忽视部分成功
当工作流在完成部分步骤后失败时,确保状态一致性,而不是让系统处于部分更新的状态。为已完成的步骤实现补偿操作。
缺乏恢复路径
失败后没有恢复选项的 Agent 会造成不良的用户体验。设计优雅降级策略,即使在某些功能失败时也能维持核心功能。
监控与告警设置
生产就绪需要监控基础设施:
- 每 5 分钟刷新一次的实时错误率仪表板
- 针对异常故障模式的告警阈值(3σ 检测)
- 每周可靠性报告,追踪 MTTR 和错误趋势
- 针对 recurring 故障的根本原因分析模板
- 可用性与时延目标的 SLA 追踪
设置告警时,区分需要即时响应的严重故障和供审查的信息性错误。
案例研究:生产环境故障响应
考虑一个典型场景:一个处理客户支持工单的 AI Agent 在邮件 API 间歇性返回 503 错误时发生故障。如果没有适当的错误处理,Agent 要么崩溃,要么留下工单未被处理。
使用 SmaugBrain 的实现后,Agent 会自动使用指数退避重试,在连续失败 5 次后触发熔断器,记录结构化错误详情,并在熔断器持续打开超过 10 分钟后升级到人工操作员。这确保了工单处理能够以最小的干扰继续进行。
常见问题解答
问:如何在 AI Agent 中处理 API 速率限制?
答:为重试延迟实现带抖动的指数退避。当速率限制被反复命中时使用熔断器。对于生产 workload,考虑向 API 提供商申请更高的速率限制。SmaugBrain 自动管理支持的集成中的速率限制退避。
问:重试和降级策略有什么区别?
答:重试是再次尝试相同的操作,适用于瞬时故障。降级是在主方法失败时执行替代逻辑,适用于成功不可或缺的关键操作。优先使用重试,降级作为安全网。
问:如何调试 Agent 失败的原因?
答:检查结构化日志中的错误消息和执行上下文。查看追踪记录以了解哪个工具调用失败及其原因。寻找重复超时或特定错误代码等模式。对于复杂故障,临时启用调试日志。
问:AI Agent 是否应该对所有错误尝试自我恢复?
答:不是。自我恢复适用于 Agent 有足够上下文进行调整的语义错误。对于持久性故障、认证问题或业务逻辑违规,应升级到人工处理。过于激进的自我恢复可能掩盖系统性问题。
问:如何防止 token 上限错误?
答:为大输入实现上下文分块,为长对话使用基于摘要的上下文管理,并监控 token 使用模式。设置合理的限制,并在接近阈值时发出告警。
问:哪些指标对 Agent 可靠性最重要?
答:重点关注按操作类型划分的错误率、延迟百分位数、重试成功率和平均恢复时间(MTTR)。每周追踪这些指标,以便在用户察觉之前发现性能退化。
问:如何测试 Agent 中的错误处理?
答:使用混沌工程原则:向 API 调用注入故障、模拟网络超时、测试熔断器行为。创建涵盖 Agent 可能遇到的每条错误路径的测试场景。验证恢复流程按预期工作。
结论
健壮的错误处理和可观测性是生产环境 AI Agent 的关键。通过实施重试模式、熔断器、结构化日志和全面的监控,您可以构建能够优雅处理故障同时保持系统可靠性的 Agent。
从实施清单开始,配置 SmaugBrain 的内置错误处理功能,并根据生产指标持续改进。访问 SmaugBrain.com 了解更多关于构建可靠 AI Agent 工作流的信息。