AI Agent 护栏:在生产环境中平衡自主性与安全性
引言
AI Agent 正在改变企业自动化复杂工作流的方式。从客户支持到数据分析,Agent 现在能够以越来越高的复杂程度处理多步骤任务。但每个生产部署的核心都存在一个关键张力:**AI Agent 应该拥有多少自主权?
给予过多自由度,会面临昂贵错误、数据泄露或声誉受损的风险;给予过多限制,则本质上只是在多步骤的聊天机器人——错失了使 Agent 本身具备价值的生产力提升。
本指南探讨平衡 Agent 自主性与运营安全的实用护栏策略。我们将涵盖实施模式、决策框架以及来自生产系统的真实案例。
什么是 AI Agent 护栏?
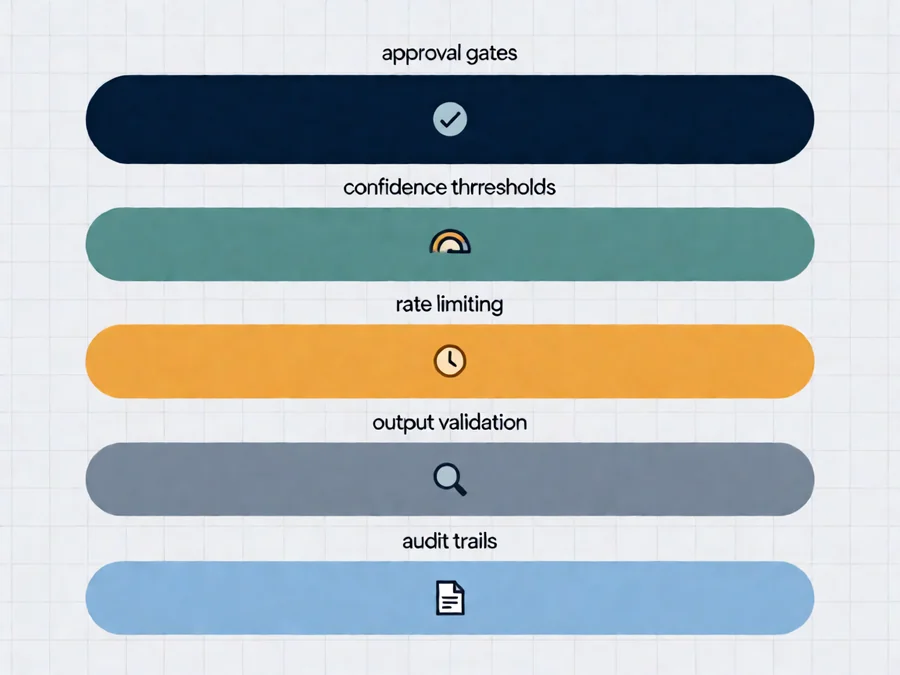
护栏是自动检查、策略和保障机制,在不要求人类对每个动作进行监督的情况下约束 Agent 行为。可以将其类比为汽车的安全带——你希望 Agent 快速高效地运行,但也需要有系统来防止灾难性故障。
常见的护栏类别包括:
– **权限边界**:Agent 无需审批即可执行哪些操作?
– **输出验证**:Agent 的响应是否符合质量和安全标准?
– **速率限制**:每分钟允许多少次 API 调用或工具执行?
– **数据访问控制**:Agent 可以读取或修改哪些信息?
– **成本管控**:每项任务或每个会话的最大支出是多少?
– **升级触发条件**:Agent 何时必须暂停并通知人工介入?
自主性-安全性谱系
并非所有任务都需要相同级别的护栏。一个好的起点是思考你的 Agent 在自主性谱系中的位置:
自主级别
描述
典型应用场景
护栏强度
**只读**
Agent 只能访问和汇总信息
研究、报告、知识检索
最低限度——重点在数据访问控制
**草稿模式**
Agent 创建内容,但需人工审核后方可执行
邮件起草、报告生成、代码审查
中等——对敏感输出要求人工审核
**受监督执行**
Agent 自主行动,但实时受到监控
客户支持分流、数据处理
较高——实时监控并具备手动覆盖能力
**完全自主**
Agent 在既定边界内独立运行
内容排期、常规维护、监控告警
非常高——全面的审计追踪和回滚机制
关键洞察 :大多数生产部署应从「受监督执行」层级起步,仅在证明可靠性和完成全面测试后才能逐步过渡到完全自主。
实施模式
模式一:审批闸门
审批闸门是明确的检查点,Agent 提议的操作在执行前需要人工确认。这是最保守的方式,适用于高风险操作。
适用场景 :财务交易、数据库修改、面向客户的通信、任何可能导致不可逆变更的操作。
实施示例:
“`
if action_type in [“DELETE”, “UPDATE”, “PAYMENT”]:
if confidence_score < 0.95:
升级至人工审批人
等待审批或拒绝
记录决策及理由
“`
模式二:置信度阈值
不使用硬性的审批闸门,而是通过置信度评分来决定操作是自动执行还是需要审核。这平衡了速度和安全性。
适用场景 :中度风险操作,其中大多数操作风险较低,但偶发的边缘情况需要人工判断。
关键组件:
– **置信度模型**:为每项提议的操作分配概率评分
– **阈值校准**:设定自动执行的最低置信度
– **回退协议**:明确置信度低于阈值时的处理方式
模式三:速率限制与配额
通过限制 Agent 执行特定操作的频率,防止资源耗尽和成本超支。
常见速率限制:
– 每分钟 API 调用次数
– 每小时数据库写入次数
– 每次会话的工具执行次数
– 每日成本支出上限
最佳实践 :从保守的限制开始,随着对 Agent 可靠性的信心增强而逐步放宽。
模式四:输出验证
在 Agent 输出到达用户或下游系统之前,根据定义的标准对其进行验证。这可以捕获幻觉、格式错误和政策违规。
验证层级:
1. **语法检查**:输出是否符合预期格式?
2. **策略检查**:输出是否违反任何业务规则或合规要求?
3. **质量检查**:输出是否达到最低质量标准?
4. **安全检查**:输出是否包含敏感信息或提示注入尝试?
模式五:审计追踪与回滚
每项自主操作都应留下可追溯的记录。全面的日志记录支持调试、合规审计,以及在出现问题时——至关重要的——回滚能力。
应记录的内容:
– 输入提示和上下文
– 采取的行动及调用的工具
– 做出的决策及理由
– 各步骤的置信度评分
– 人工干预和审批记录
真实案例
客户支持 Agent
自主级别 :受监督执行
已实施的护栏:
– 针对常见场景的回复模板(退款政策、物流时效)
– 情感检测触发升级至人工客服
– 无支付处理 API 的访问权限
– 所有回复记录并每周审查
效果 :70% 的咨询无需人工干预即可解决,客户满意度评分与人工客服持平。
数据分析 Agent
自主级别 :草稿模式
已实施的护栏:
– 数据库只读访问
– 所有 SQL 查询验证为仅 SELECT 操作
– 结果通过统计合理性测试交叉验证
– 异常数据在报告生成前标记供人工审核
效果 :将分析时间从数小时缩短至数分钟,同时保持数据准确性。
内容创作 Agent
自主级别 :完全自主(试用期满后)
已实施的护栏:
– 通过少样本示例强制执行语气和风格指南
– 发布前进行抄袭检查
– SEO 元数据验证
– 品牌关键内容的最终审批工作流
效果 :在 90 天试用期后,每月发布 50+ 篇文章,质量一致且零品牌事故。
决策框架:选择你的护栏策略
使用以下框架确定适合你用例的正确护栏配置:
步骤 1:评估风险等级
– 错误的潜在影响是什么?(低/中/高/灾难性)
– 错误是否可以轻松纠正?(是/部分/否)
– 谁会受到错误影响?(内部团队/客户/公众)
步骤 2:评估频率
– Agent 将以何种频率运行?(单次/定期/每日/全天候)
– 可接受故障率是多少?(0%/<1%/<5%/未知)
步骤 3:考虑复杂度
– 任务环境有多可预测?(静态/动态/混乱)
– 存在多少边缘案例?(少/中等/多)
步骤 4:匹配护栏模式
风险等级
频率
推荐模式
低
单次
最低限度——仅基础验证
低-中
定期
置信度阈值 + 速率限制
中
每日
审批闸门 + 输出验证
高
全天候
完整护栏套件 + 人工监督
灾难性
任意
绝不完全自主——始终受监督
常见陷阱
陷阱一:过早过度设计
为每种可能场景一开始就部署全面的护栏会产生摩擦并减缓迭代。从最小保障开始,在识别出实际故障模式后再逐步扩展。
解决方案 :使用上述风险框架为每项护栏提供依据。如果你无法阐明其必要性,请重新考虑是否真的需要它。
陷阱二:虚假安全感
护栏降低风险但不会消除风险。即使具有完美护栏的 Agent,如果底层模型存在盲区或威胁行为者发现新型攻击向量,仍可能失败。
解决方案 :将护栏与持续监控、定期渗透测试和质疑假设的文化相结合。
陷阱三:忽视提示注入风险
即使有护栏,复杂的提示注入攻击也可能绕过验证。攻击者可能构造看起来无害的输入,导致 Agent 执行非预期的操作。
解决方案 :实施输入清理,对照已知攻击模式进行验证,并对任何修改外部系统的操作保持人工监督。
陷阱四:在动态环境中使用静态护栏
今天有效的护栏,明天可能不足以应对 Agent 遇到的新场景或业务流程的演变。
解决方案 :每季度审查并更新护栏,或在 Agent 运行环境发生重大变化时立即更新。
陷阱五:将自主性等同于智能
高度智能的 Agent 并不自动意味着安全。缺乏适当约束的智能可能导致更复杂的故障,更难被检测到。
解决方案 :在能力开发的同时优先考虑安全工程。将护栏视为一等公民,而非事后补充。
衡量护栏有效性
跟踪以下指标以评估护栏是否按预期工作:
指标
衡量内容
目标值
**干预率**
需要人工审核的操作百分比
成熟 Agent <10%
**误报率**
被错误拦截的安全操作
<5%
**逃逸率**
未被捕获的不安全操作
0%(不可妥协)
**平均检测时间**
发现问题所需速度
<5 分钟
**回滚成功率**
成功撤销问题操作的百分比
>95%
**用户信任评分**
用户对 Agent 安全性的信心(基于调查)
>4/5
最佳实践总结
1. **保守起步**:从更严格的护栏开始,随着信心增强逐步放宽
2. **多层防御**:不要依赖单一护栏——使用多种互补检查
3. **记录一切**:全面的审计追踪支持调试和持续改进
4. **严格测试**:在生产前使用对抗性测试发现护栏中的漏洞
5. **为失败做准备**:假设护栏会失效,并据此设计回退机制
6. **定期审查**:安排定期的护栏配置审计
7. **平衡自主与控制**:优化正确的组合,而非最大限制
结论
构建生产就绪的 AI Agent 需要仔细关注自主性与安全性的平衡。有效的护栏使 Agent 能够自信地运行,同时保护组织免遭可预防的风险。
关键在于为你的特定用例找到正确的配置——不存在通用模板。使用本指南概述的决策框架评估你的风险概况,选择合适的模式,并随着 Agent 成熟逐步实施。
请记住:护栏不是为了限制 Agent 能做什么——而是为了确保它在长期内能够更安全、更可靠地做更多事情。
—
常见问题
问:如何知道我的 Agent 是否已准备好完全自主运行?
答:寻找持续可靠性的证据:在 1,000+ 次操作中错误率低于 1%,无需人工干预即可成功处理边缘情况,以及用户对准确性和及时性均给予积极反馈。即便如此,也应保留一些监督机制以防灾难性故障。
问:护栏会不会让 Agent 运行过慢?
答:设计不良的护栏可能造成不必要的摩擦。目标是智能约束——最小化的检查捕获最大化的风险。在可能的情况下使用置信度阈值和并行验证,在保持安全性的同时维持吞吐量。
问:有了护栏如何防范提示注入?
答:采用多层防御:输入清理、输出验证、行为监控和最小权限原则。没有任何单一护栏能阻止所有注入尝试,但综合使用可以建立大部分攻击无法逾越的实质性屏障。
问:不同的 Agent 是否应有不同的护栏配置?
答:是的,绝对应该。处理客户退款请求的 Agent 需要比生成内部研究摘要的 Agent 更严格的财务控制。你的配置应基于风险评估,而非技术能力。
问:我应该多久审查和更新一次护栏?
答:以季度审查作为基线。以下情况应立即更新护栏:(1) Agent 遇到新的故障模式,(2) 业务需求发生重大变化,(3) 添加了新功能或集成,(4) 行业最佳实践有所演进。
问:护栏(guardrails)和护卫犬(guard dogs)有什么区别?
答:护栏防止操作发生或自动阻止不安全操作。护卫犬在问题发生后检测和响应。你需要两者——主动预防和被动检测——才能实现全面保护。
问:我能否与第三方 AI 提供商一起使用护栏?
答:可以,但有限制。第三方提供商可能限制某些操作或日志记录功能。设计护栏以在提供商约束内工作,并在可能时将敏感操作通过你自己的基础设施运行。
探索 SmaugBrain——使用企业级护栏构建生产就绪的 AI Agent。立即开始免费试用。
Cookie Consent We use cookies to improve your experience on our site. By using our site, you consent to cookies.
Manage your cookie preferences below:
Essential cookies enable basic functions and are necessary for the proper function of the website.
Cookie Preferences
This cookie is used to store the user's cookie consent preferences.
30 days
These cookies are used for managing login functionality on this website.
wordpress_logged_in
Used to store logged-in users.
Persistent
wordpress_sec
Used to track the user across multiple sessions.
15 days
wordpress_test_cookie
Used to determine if cookies are enabled.
Session
Statistics cookies collect information anonymously. This information helps us understand how visitors use our website.
Google Analytics is a powerful tool that tracks and analyzes website traffic for informed marketing decisions.
Service URL: policies.google.com (opens in a new window)
__utma
ID used to identify users and sessions
2 years after last activity
__utmt
Used to monitor number of Google Analytics server requests
10 minutes
__utmb
Used to distinguish new sessions and visits. This cookie is set when the GA.js javascript library is loaded and there is no existing __utmb cookie. The cookie is updated every time data is sent to the Google Analytics server.
30 minutes after last activity
__utmc
Used only with old Urchin versions of Google Analytics and not with GA.js. Was used to distinguish between new sessions and visits at the end of a session.
End of session (browser)
__utmz
Contains information about the traffic source or campaign that directed user to the website. The cookie is set when the GA.js javascript is loaded and updated when data is sent to the Google Anaytics server
6 months after last activity
__utmv
Contains custom information set by the web developer via the _setCustomVar method in Google Analytics. This cookie is updated every time new data is sent to the Google Analytics server.
2 years after last activity
__utmx
Used to determine whether a user is included in an A / B or Multivariate test.
18 months
_ga
ID used to identify users
2 years
_gali
Used by Google Analytics to determine which links on a page are being clicked
30 seconds
_ga_
ID used to identify users
2 years
_gid
ID used to identify users for 24 hours after last activity
24 hours
_gat
Used to monitor number of Google Analytics server requests when using Google Tag Manager
1 minute
_gac_
Contains information related to marketing campaigns of the user. These are shared with Google AdWords / Google Ads when the Google Ads and Google Analytics accounts are linked together.
90 days