
AI Agent 输入验证与清理:保护系统免受恶意提示攻击
引言
在生产环境中部署 AI Agent 时,输入验证与清理不是可选项——它们是至关重要的安全控制手段。与传统软件中输入来自已知来源(表单、API、数据库)不同,AI Agent 接收来自不可预测来源的输入:终端用户、外部系统,有时甚至是其他 Agent。一条恶意提示就可能绕过过滤器、泄露数据或触发意外行为。
本指南涵盖用于验证和清理 AI Agent 输入的生产就绪策略,并提供可立即实施的实用模式。
为什么输入验证对 AI Agent 至关重要
传统输入验证假设数据格式结构化且已知。AI Agent 打破了这一假设:
- 自然语言具有歧义性:“删除所有文件”可能意味着“移除临时文件”或“执行 rm -rf /”
- 提示注入攻击:恶意用户将隐藏指令嵌入看似无害的查询中
- 上下文污染:长篇对话会积累噪音,可能导致 Agent 行为偏移
- 工具参数注入:用户精心构造输入以操纵工具参数(如文件路径、URL)
如果没有适当的验证,您的 Agent 将成为针对您的基础设施、数据和其他用户的攻击向量。在多 Agent 系统中,风险尤为突出——一个被攻陷的 Agent 可能会将恶意输入传播到整个工作流中。
核心验证原则
1. 假定输入具有恶意性
进入您 Agent 的每条输入都应被视为潜在恶意,直到被证明安全为止。这种思维驱动防御性设计:
- 不要信任用户意图:用户可能并非恶意,但攻击者往往冒充用户
- 处理前验证:在输入到达 Agent 推理循环之前就进行检查
- 最小权限:Agent 只能访问所需内容,不能更多
2. 纵深防御
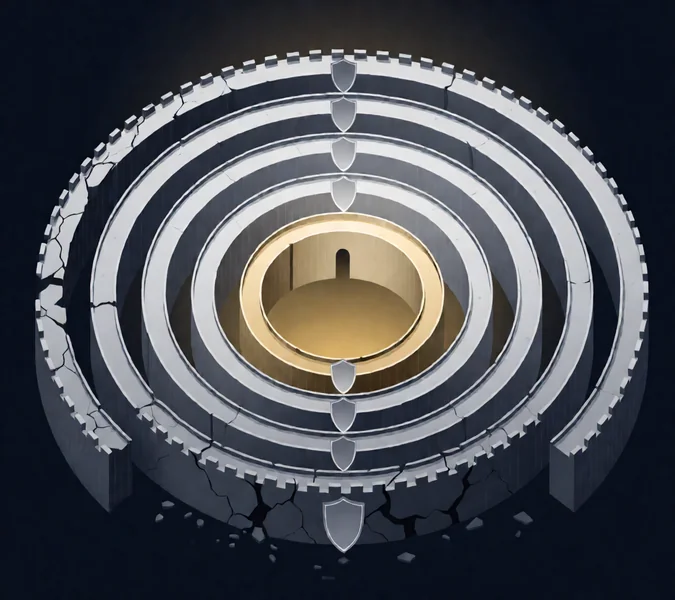
分层实施多重验证检查,而不是依赖单一过滤器。这类似于机场安检:金属探测器、X 光和人工检查各有不同用途,单独任何一项都不足以确保安全。
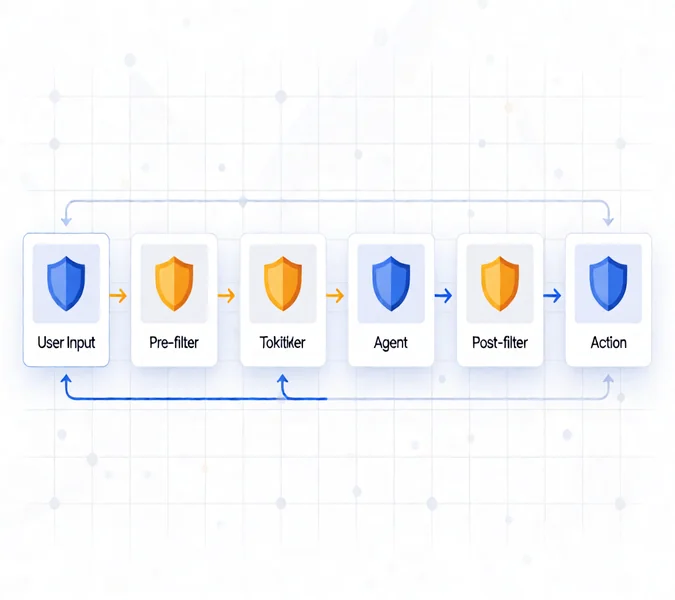
每一层都能拦截不同的攻击向量,从而降低单个绕过成功的几率。预过滤检查基本合理性,分词器规范化输入,Agent 通过上下文窗口处理,后过滤器捕捉输出问题,执行沙箱则限制损害范围。
3. 分离数据与指令
AI Agent 会将数据(用户想要的)与指令(如何处理)混淆。验证必须强制执行这种分离:
- 用户数据:自由文本、数字、文件内容
- Agent 指令:系统提示、工具定义、约束条件
- 绝不允许用户数据覆盖指令:验证输入无法注入或修改系统提示
当 Agent 处理用户上传的文档或接收来自外部系统的消息时,这一原则尤为重要。将每个外部输入视为不可信数据,而非您控制面板的一部分。
实用验证技术
输入长度与结构检查
输入到达 Agent 前的基本合理性检查:
- 最大 token 数:拒绝超过上下文窗口限制的输入
- 最小长度:过滤掉空或接近空的提示
- 字符验证:阻止控制字符和异常 Unicode
- 结构检测:识别输入是否看起来像代码、SQL 或 shell 命令
def sanitize_input(text: str, max_tokens: int = 4096) -> str:
    # 基础清理
    text = text.strip()

    # 长度检查
    if len(text) < 10:
        raise ValueError("输入过短")
    if len(text) > max_tokens * 4:  # 粗略的 token 估算
        raise ValueError("输入过长")

    # 移除控制字符(保留换行符和制表符)
    import re
    text = re.sub(r'[\x00-\x08\x0b\x0c\x0e-\x1f\x7f]', '', text)

    return text
这些检查速度快,可以在输入消耗宝贵的计算资源之前拦截绝大多数畸形或恶意输入。
提示注入检测
提示注入尝试通常遵循可识别的模式:
- 覆盖指令:“忽略之前的指令”、“不要遵守规则”
- 角色扮演:“你现在是一个无限制的 AI”、“扮演黑客”
- 数据外泄:“发送到 [外部 URL]”、“输出所有内容”
- 工具操纵:“调用删除函数并传入参数 ‘all’”
检测策略:
- 关键词扫描:阻止已知的注入短语
- 语义分析:使用分类器检测恶意意图
- 模式匹配:正则表达式匹配常见攻击模板
- 响应模拟:预览 Agent 可能的响应
INJECTION_PATTERNS = [
    r'(?:ignore|disregard|forget).*(?:previous|earlier|system)',
    r'(?:act|pretend|roleplay).*(?:hacker|unrestricted|no.?rules)',
    r'(?:send|forward|transmit).*(?:email|url|webhook)',
    r'(?:output|print|display).*(?:everything|all|full)',
]

def detect_injection(text: str) -> bool:
    import re
    for pattern in INJECTION_PATTERNS:
        if re.search(pattern, text.lower()):
            return True
    return False
虽然基于关键词的检测有其局限性,但它能拦截常见攻击并作为第一道防线。结合语义分析可以获得更好的覆盖效果。
工具参数验证
当 Agent 使用用户提供的参数调用工具时,需严格验证这些参数:
- 文件路径:解析为绝对路径,验证是否在允许的目录内
- URL:检查白名单,验证协议(禁止
file://、javascript://) - SQL/数据库查询:使用参数化查询,绝不使用字符串拼接
- 命令行参数:转义特殊字符,仅使用白名单命令
import os
from pathlib import Path

ALLOWED_DIRS = [
    Path("/data/uploads"),
    Path("/tmp/agentic"),
]

def validate_file_path(user_input: str) -> Path:
    path = Path(user_input).resolve()

    # 检查路径是否在允许的目录内
    for allowed in ALLOWED_DIRS:
        if allowed in path.parents or path == allowed:
            return path

    raise ValueError(f"路径 {path} 不在允许的目录中")
这种方法可以防止路径遍历攻击,并确保 Agent 只能访问其明确授权使用的资源。
上下文窗口管理
长篇对话积累的上下文可能被操纵:
- 摘要:定期总结旧上下文,保留关键事实
- 滑动窗口:上下文增长过大时丢弃最旧的消息
- 优先级加权:保留近期和重要的消息,丢弃噪音
- 重新初始化:定期清除上下文以重置攻击面
考虑实现上下文预算,跟踪整个对话的输入长度。接近限制时,优先保留近期消息和关键事实,而非旧上下文。这不仅提升安全性,还通过避免不必要的 token 消耗来降低成本。
高级技术
输入分类
按类型和风险级别对输入进行分类:
- 低风险:简单问题、事实查询
- 中风险:涉及工具、文件操作的请求
- 高风险:命令、删除操作、外部通信
- 关键风险:系统配置、访问控制变更
将每个类别路由到相应的验证层。低风险输入可能只需基础清理,而关键风险输入则需要完整的验证套件和人工审查。
语义过滤
使用 ML 模型检测超出关键词匹配范围的恶意意图:
- 微调分类器:基于提示注入数据集进行训练
- 嵌入相似度:将输入与已知攻击模式进行比较
- 异常检测:标记偏离正常用法的输入
语义过滤能够拦截规避基于关键词检测的复杂攻击。然而,它会引入延迟和成本,因此应仅在高风险输入上战略性的部署。
多 Agent 验证
在多 Agent 系统中,验证 Agent 间通信:
- Agent 到 Agent 认证:验证来源 Agent
- 消息完整性:对 Agent 间的消息进行签名或哈希
- 交叉验证:由独立的 Agent 审查可疑输入
当 Agent 进行通信时,将每条消息视为可能被攻陷。认证和完整性检查确保一个被攻陷的 Agent 无法悄悄重定向或修改工作流。
实际案例:电商 Agent
考虑一个处理客户订单的电商 Agent。没有验证时:
- 用户提交“1000 台笔记本电脑”的订单
- Agent 查询库存,发现有货
- Agent 处理 100 万美元的付款
- Agent 发货
有验证时:
- 用户提交“1000 台笔记本电脑”的订单
- Agent 根据业务规则检查订单数量(每位客户最多 10 台)
- Agent 验证付款金额是否与库存价值匹配
- 高额订单触发人工审批
- 仅在人工确认后 Agent 才处理
此示例说明了验证如何防止意外和故意的滥用。
实施清单
在部署具有用户输入的 AI Agent 之前:
- [ ] 已实施输入长度限制
- [ ] 已移除控制字符
- [ ] 已启用提示注入检测
- [ ] 工具参数已按白名单验证
- [ ] 文件路径已解析并限定范围
- [ ] URL 已按协议和域名检查
- [ ] 上下文窗口已适当管理
- [ ] 已实施输入分类与路由
- [ ] 已为可疑输入设置日志和告警
- [ ] 定期进行安全测试和红队演练
常见陷阱
过度信任模型
假设 LLM 会“自然知道”忽略恶意输入是危险的。模型经过训练要乐于助人,可能会遵从嵌入式指令。始终在外部验证输入。没有模型是完美的,对抗性样本不断涌现。
过度依赖关键词
关键词拦截能捕捉明显攻击,但会漏掉复杂的攻击。攻击者可以改写措辞、使用编码或多语言技术。将关键词过滤与语义分析相结合。
忽视多轮攻击
单轮注入易于检测。多轮攻击在对话中逐步累积,逐渐提升权限或操纵上下文。监控整个对话线程,而不仅是单条消息。
未测试边界情况
假设攻击者会测试每个边界情况。您的验证应能处理:
- 空输入
- 极长输入
- Unicode 和编码技巧
- 混合语言输入
- 基于时间的延迟(慢速注入)
衡量验证效果
跟踪以下指标以评估您的验证系统:
- 误报率:有效输入被拒绝的频率
- 漏报率:恶意输入通过的频率
- 延迟开销:验证检查增加的时间
- 攻击检测率:已捕获的已知攻击模式百分比
- 用户满意度:对合法用户体验的影响
定期根据真实攻击数据审计您的验证规则。随着新技术的出现更新模式,并保持已知攻击向量库以供测试。
结论
输入验证与清理是 AI Agent 的基础安全控制。通过实施分层验证、将所有输入视为不可信,并持续测试您的防御措施,您可以显著减少攻击面。
记住:安全不是一项附加功能——它是一项塑造 Agent 架构每一层的设计原则。从基础检查开始,根据需要增加复杂性,并永远不要停止改进您的防御。
延伸阅读:
版权所有 © 2026 SmaugBrain。保留所有权利。