
# AI Agent RAG 实现:构建高效检索系统的生产指南
AI Agent RAG 实现:构建高效检索系统的生产指南
检索增强生成(RAG)已成为需要基于事实和最新信息生成响应的生产级 AI Agent 的标准架构。与纯提示工程或微调方法不同,RAG 在不重新训练底层模型的情况下,为 Agent 提供了访问动态知识库的能力。
然而,正确实现 RAG 比教程中描述的要困难得多。一个自信地产生幻觉的 RAG 系统和一个准确检索的 RAG 系统之间的差异,往往取决于大多数指南完全忽略的实现细节。
本指南涵盖了在为 AI Agent 构建生产级 RAG 系统时需要做出的实际决策——分块策略、嵌入模型、检索架构、重排序以及真正重要的评估指标。
什么是 RAG 以及为什么 AI Agent 需要它
RAG 通过外部检索的信息来增强语言模型的响应生成。Agent 查询知识库,检索相关的文档或段落,并将其与用户的原始提示一起纳入生成上下文。
对于 AI Agent 来说,RAG 解决了三个关键问题:
- 知识时效性:Agent 可以访问当前信息,无需重新训练模型
- 事实依据:响应引用来源而非生成看似合理的虚构内容
- 领域专业性:Agent 可以使用专有或内部文档在专业上下文中运行
没有 RAG,Agent 要么依赖训练数据截止日期,要么为每个查询调用外部 API,要么在面对分布外问题时出现幻觉。
真正有效的分块策略
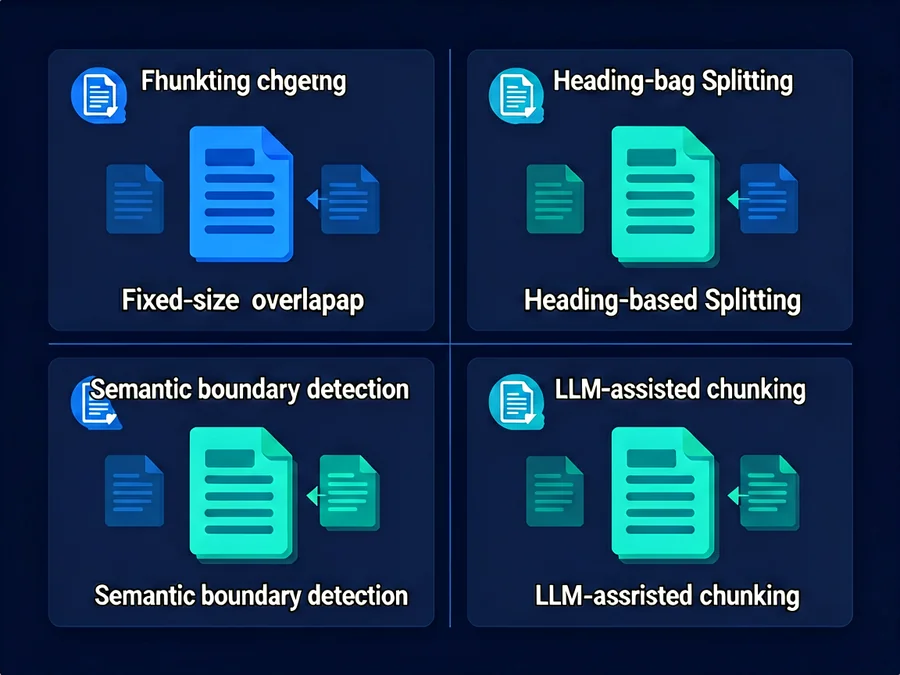
文档在嵌入前的分段方式,对检索质量的影响超过任何其他单一因素。糟糕的分块会产生噪音;好的分块能保留语义边界。
带重叠的固定大小分块
最简单的方法是将文档分割成具有重叠边界的固定大小块。典型参数:
- 块大小:256–1024 个 token
- 重叠:50–200 个 token
- 分隔符:段落断行、章节标题或自然边界
固定大小分块对于结构化文档(如常见问题解答或手册条目)效果尚可。然而,它经常将连贯的概念跨越块边界分割,导致检索返回不完整的上下文片段。
语义分块
语义分块识别文档主题发生显著变化的自然断点。技术包括:
- 基于标题的分割:使用文档结构(H1、H2、H3)作为边界
- 基于长度的分组:将句子分组直到达到长度阈值,然后评估语义连贯性
- LLM 辅助分块:使用模型本身来识别逻辑部分
语义分块通常能产生更高的检索精度,因为每个块代表一个完整的思想或概念。权衡点在于摄入时的计算开销。
| 分块策略 | 最佳适用场景 | 平均精度 | 实现复杂度 |
|---|---|---|---|
| 带重叠的固定大小 | 结构化文档、常见问题解答 | 中等 | 低 |
| 基于标题 | 技术文档 | 高 | 低 |
| 语义边界检测 | 非结构化文本 | 高 | 中等 |
| LLM 辅助 | 复杂领域文本 | 非常高 | 高 |
多粒度分块
高级 RAG 系统同时维护多种块大小。小块捕捉具体细节;大块提供上下文支撑。在检索时,系统可以跨粒度组合结果或根据查询复杂度进行选择。
嵌入模型选择
您的嵌入模型决定了系统理解查询与文档之间语义相似性的能力。自 2023 年以来,这个领域已经发生了巨大变化。
生产就绪的嵌入模型
| 模型 | 维度 | 最大 Token 数 | 典型用例 |
|---|---|---|---|
| text-embedding-3-large | 3072 | 8191 | 通用目的,高准确度 |
| text-embedding-3-small | 1536 | 8191 | 成本敏感的部署 |
| mxbai-embed-large-v1 | 1024 | 512 | 开源替代方案 |
| nomic-embed-text-v1.5 | 768 | 8192 | 长文档、本地部署 |
嵌入模型权衡
较大的嵌入维度通常与更好的检索质量相关,但会增加存储成本并降低向量搜索性能。3072 维度的 text-embedding-3-large 提供了最先进的 MTEB 基准分数,但需要更多的每向量内存。
对于处理数十万文档的 AI Agent,考虑在初始嵌入后进行降维,或使用乘积量化等技术来减少内存占用同时保持检索准确性。
检索架构
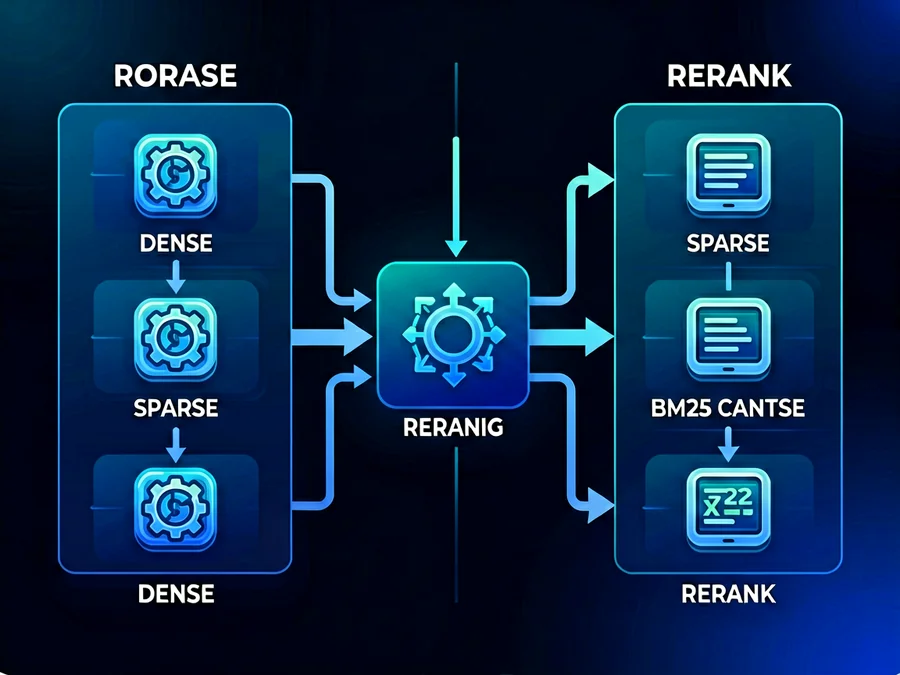
简单的向量相似度搜索对于生产级 RAG 来说通常不够用。高级检索架构结合多种信号来提取最相关的上下文。
稀疏 + 密集混合检索
将密集向量搜索与稀疏词汇搜索(BM25)相结合,可以同时捕捉语义相似性和精确关键词匹配。这种混合方法特别适用于:
- 具有精确术语的技术文档
- 包含产品名称、版本号或缩略语的查询
- 嵌入可能较弱的多语言内容
Elasticsearch、OpenSearch 或 Weaviate 等工具原生支持混合搜索,返回密集和稀疏得分的加权组合。
多查询检索
与其嵌入单个查询,不如生成多个查询变体并从每个变体中进行检索。这种技术由 Google 的 HyDE(假设文档嵌入)方法推广,通过捕捉用户意图的不同方面来提高召回率。
对于 AI Agent,当 Agent 需要从多个文档部分综合信息时,多查询检索特别有价值。Agent 可以为每次检索轮次生成专门的子查询。
元数据过滤检索
当您的知识库包含来自不同领域、时间段或访问级别的文档时,元数据过滤可以将检索限制在相关子集内。这提高了精度并通过减少搜索的向量空间来降低成本。
常见的元数据过滤器包括:
- 文档类型(政策、教程、参考)
- 创建日期或版本
- 作者或部门
- 访问控制标签
重排序:关键缺失步骤
大多数 RAG 实现跳过重排序,接受初始检索返回的任何结果。这是一个重大的质量差距。重排序使用更复杂的模型对初始检索候选项重新评分,提升真正相关的文档同时降低误报的优先级。
交叉编码器重排序
交叉编码器将查询和文档一起通过 Transformer 模型处理,产生相关性得分。虽然计算成本高(无法使用向量索引),但它们擅长理解双编码器嵌入遗漏的细微相关性。
生产工作流程通常用密集/稀疏搜索检索 50–100 个候选项,然后用交叉编码器对前 10–20 个进行重排序,再传递给 LLM。
重排序模型
| 模型 | 速度 | 准确度 | 许可证 |
|---|---|---|---|
| BGE-Reranker-V2-M3 | 快 | 高 | MIT |
| cohere-rerank-english | 中等 | 非常高 | 商业 |
| jina-reranker-v2 | 快 | 高 | Apache 2.0 |
真正重要的评估指标
衡量 RAG 质量需要分别评估检索和生成两个组件。
检索指标
- Recall@K:在前 K 个结果中找到相关文档的百分比
- NDCG@K:归一化折损累积增益,考虑排名位置
- MRR:平均倒数排名,衡量相关结果出现的速度
生成指标
- 忠实度:生成的声明是否得到检索上下文的支持
- 答案相关性:响应在多大程度上解决了原始问题
- 上下文利用率:检索到的上下文实际用于生成的百分比
端到端评估
对于生产级 AI Agent,合成评估数据集至关重要。从您的知识库创建问答对,然后测量:
- 正确回答问题的百分比
- 包括检索在内的平均响应延迟
- 包括嵌入和生成在内的每次查询成本
- 抽样响应的用户满意度评级
常见的 RAG 实现陷阱
即使是经验丰富的团队在部署 AI Agent 的 RAG 系统时也会遇到这些反复出现的问题。
陷阱 1:忽视查询转换
原始用户查询很少与文档语言匹配。有效的 RAG 系统在检索前转换查询——扩展缩写、转换为搜索友好格式,或生成与文档风格匹配的假设答案。
陷阱 2:过度分块或分块不足
过小的块会丢失上下文;过大的块会稀释相关性信号。监控不同块大小的检索质量并根据文档结构调整。
陷阱 3:静态嵌入阈值
使用固定的相似度阈值(例如余弦相似度 > 0.7)往往无法应对多样化的文档类型。考虑基于查询难度使用动态阈值,或为实现低置信度检索的备用策略。
陷阱 4:忘记上下文窗口限制
检索到的上下文必须适合 LLM 的上下文窗口,同时要考虑系统提示、对话历史和输出要求。实施上下文预算以防止截断错误。
生产部署检查清单
| 组件 | 检查项 |
|---|---|
| 向量数据库 | 可扩展索引、容错、元数据过滤支持 |
| 嵌入管道 | 批处理、增量更新、模型版本管理 |
| 检索层 | 混合搜索、重排序、备用策略 |
| 上下文管理 | 块大小优化、重叠调整、去重 |
| 评估 | 合成测试集、监控仪表板、A/B 测试框架 |
| 成本控制 | 嵌入成本优化、缓存频繁查询、速率限制 |
常见问题
我应该嵌入多少文档以实现最佳检索?
使用适当的索引,向量搜索性能在多达数百万文档时都能平稳退化。对于 AI Agent,专注于检索质量而不是限制文档数量。使用 HNSW 等近似最近邻索引,实现大规模下的亚秒级查找。
我应该使用商业还是开源嵌入模型?
text-embedding-3-large 等商业模型提供更高的准确度,但会产生按 token 计费的成本。BGE 或 Nomic 等开源替代方案对于大规模部署具有成本效益,并且可以在本地运行。在确定之前,在您的特定文档语料库上测试两者。
我该如何处理过时或废弃的文档?
在元数据中实现版本跟踪,并在检索时优先考虑时效性。为时效性文档设置过期日期,并在检索结果中标记陈旧内容。考虑为当前和归档文档维护单独的索引。
我应该瞄准多大的上下文窗口?
在检索召回和生成质量之间取得平衡。较小的上下文(4K–8K token)倾向于产生更集中的响应,但可能遗漏重要细节。较大的上下文(16K–32K)提高召回率,但增加成本和延迟。从 8K token 开始,仅在评估显示召回缺陷时扩展。
在没有人工标注者的情况下,我如何评估 RAG 质量?
使用从您自己的文档创建的合成评估数据集。生成问答对,然后测量检索召回和生成忠实度。RAGAS 和 DeepEval 等工具自动化了这个评估管道并提供综合质量分数。
开始使用 SmaugBrain
SmaugBrain 为需要强大 RAG 能力的生产级 AI Agent 提供基础设施。我们的 Agent 框架支持自定义工具集成,使您能够构建可从原型扩展到生产的检索增强工作流。
了解更多关于 SmaugBrain 的信息,从今天开始构建生产级 AI Agent。
关键要点
- 分块策略比你想象的重要:对于复杂文档,语义和多粒度分块明显优于固定大小方法。
- 混合检索必不可少:将密集向量搜索与词汇 BM25 结合,以在各种查询类型中获得最佳召回率。
- 始终进行重排序:对顶部候选项进行交叉编码器重排序,显著改善最终检索精度。
- 测量重要的指标:分别跟踪检索指标(召回率、NDCG)和生成指标(忠实度、相关性)。
- 检索前转换查询:原始用户查询往往无法与文档语言匹配;投资于查询扩展和转换。
构建有效的 RAG 系统需要在分块、检索和重排序组件上进行迭代优化。从一个简单的实现开始,建立基线指标,并根据您的评估结果系统性地优化每个组件。