
AI Agent 语义搜索与 RAG 优化:向量数据库、Embedding 模型及检索策略
语义搜索是高效的检索增强生成(RAG)系统的核心支柱。对于需要访问大型知识库并进行推理的 AI Agent 而言,能否正确实现检索,可能决定了响应是准确且贴合上下文的,还是令人沮丧的幻觉输出。本指南涵盖了构建生产级 RAG 系统时你将面临的实际决策:选择向量数据库、挑选 Embedding 模型、实施混合检索以及针对性能进行调优。
无论你是在启动新的 Agent 项目还是优化现有的 RAG 管道,本指南都为在检索堆栈的每个层面做出正确的技术选择提供了可操作的框架。
AI Agent 中的语义搜索有何不同?
传统关键词搜索完全匹配术语。语义搜索理解含义,基于概念相似性返回结果,即使精确词汇不同。对 AI Agent 来说,这一区别至关重要,因为:
- 上下文窗口有限。现代 LLM 可处理 128K-1M token,但 Agent 的知识库可能包含数百万份文档。RAG 仅检索最相关的片段,使上下文保持可控。
- 查询通常存在歧义。用户并不总是清楚自己在寻找什么。语义搜索比关键词匹配更好地处理模糊或间接的查询。
- Agent 需要事实依据。幻觉会侵蚀信任。高质量的检索确保 Agent 引用实际来源材料,而非生成听起来合理但不正确的信息。
有效的语义搜索依赖于三大支柱:Embedding 质量(向量捕捉意义的能力)、向量数据库性能(检索的速度与规模)和检索策略(查询如何转换及结果如何排序)。
为生产环境选择正确的向量数据库
向量数据库存储和索引高维 Embedding,以实现快速相似度搜索。正确的选择取决于你的规模、延迟要求和运维偏好。
主流选项对比
| 数据库 | 类型 | 规模 | 延迟 | 成本 | 适用场景 |
|---|---|---|---|---|---|
| Pinecone | 托管服务 | 1 亿+ 向量 | <100ms | 按用量计费 | 生产负载、最小运维 |
| Weaviate | 自托管/云 | 100 亿+ 向量 | <50ms | 免费(自托管) | 复杂查询、图集成 |
| Milvus | 自托管/云 | 100 亿+ 向量 | <100ms | 免费(自托管) | 大规模、多区域部署 |
| Qdrant | 自托管/云 | 10 亿+ 向量 | <50ms | 免费(自托管) | Rust 性能、过滤效率 |
| pgvector | 扩展插件(PostgreSQL) | 1 亿+ 向量 | >100ms | PostgreSQL 成本 | 已使用 PostgreSQL 的团队 |
决策框架
当需要零运维开销且能接受用量成本时,选择 Pinecone。它在简单性方面表现出色,但对基础设施的控制较少。
当需要高级过滤、图关系或与现有数据栈紧密集成时,选择 Weaviate 或 Qdrant。两者均提供强大的查询语言和丰富的元数据支持。
当处理海量规模(数十亿向量)或需要地理数据分布的多区域部署时,选择 Milvus。
如果团队已管理 PostgreSQL 且希望避免向堆栈中添加其他服务,选择 pgvector。延迟将高于专用向量数据库,但运维更简单。
Embedding 模型选择:平衡质量与成本
Embedding 模型将文本转换为高维向量。模型选择直接影响检索质量和持续成本。
模型对比
| 模型 | 维度 | 平均长度 | 成本(每千次) | 质量等级 |
|---|---|---|---|---|
| text-embedding-3-small | 1536(可变) | 8192 tokens | $0.02 | 良好 |
| text-embedding-3-large | 3072(可变) | 8192 tokens | $0.13 | 优秀 |
| bge-large-en-v1.5 | 1024 | 512 tokens | 免费(自托管) | 非常好 |
| gte-large | 1024 | 8192 tokens | 免费(自托管) | 非常好 |
| nomic-embed-text-v1.5 | 768 | 8192 tokens | 免费(自托管) | 良好 |
维度权衡
更高维度通常意味着更好的质量,但存储和计算成本也更高。一个实用的方法是:
- 384-512 维:预算敏感项目、高批量 Embedding。质量良好但非最优。
- 768-1024 维:大多数应用的最佳平衡点。质量良好且成本合理。
- 1536-3072 维:为关键应用提供最大质量,检索准确性最为重要。
批量 Embedding 策略
Embedding 成本随规模扩大。使用以下技术进行优化:
- 批量请求:尽可能将多个文本合并到单个 API 调用中。
- 缓存:存储相同文本的 Embedding 以避免重复计算。
- 选择性 Embedding:仅 Embedding 高价值内容;对临时或低优先级数据使用关键词搜索。
- 定期刷新:重新 Embedding 频繁变更的内容;静态内容保留缓存。
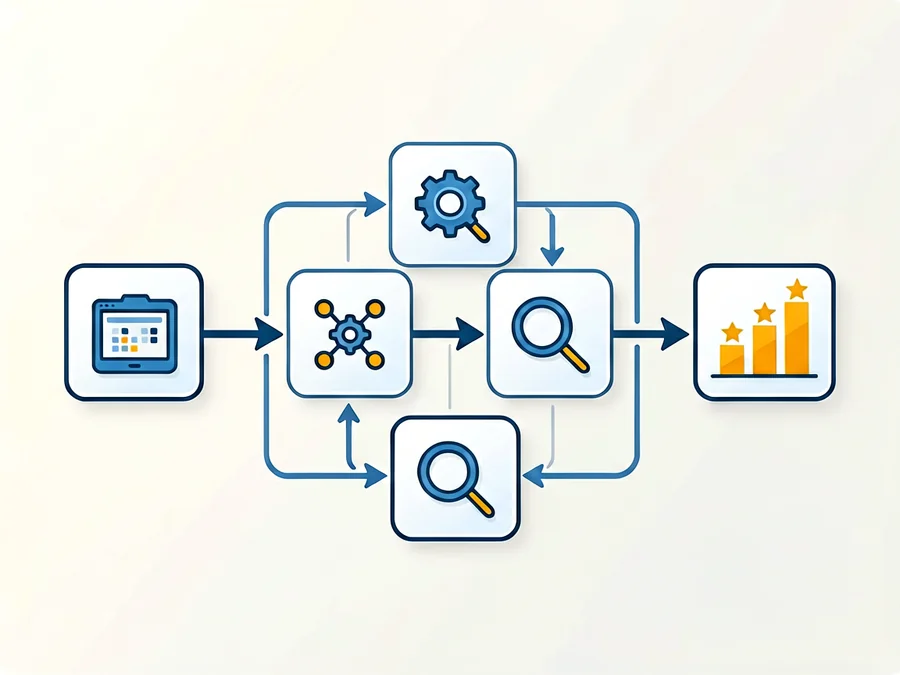
真正有效的混合检索策略
仅靠密集检索(向量相似度)往往会遗漏细微之处。混合方法通过结合多种信号获得更好的结果。
密集 + 稀疏融合
结合向量相似度(密集)与术语匹配(稀疏/关键词)。这同时捕捉语义含义和精确关键词匹配:
- RRF(倒数排名融合):对两种方法的结果进行排名,使用倒数排名公式合并排名。简单、高效、广泛应用。
- 加权融合:为密集和稀疏分数分配权重,归一化后合并。
重排序管道
初始检索后,使用交叉编码器对结果进行重排序。交叉编码器直接评估查询-文档对,比双编码器(独立编码查询和文档)提供更准确的相关性分数。
生产模式:
- 使用快速密集+稀疏搜索检索前 50 个候选项
- 使用交叉编码器模型对前 50 个候选项进行重排序
- 将前 5 个返回给 LLM
这种两阶段方法平衡了速度和质量:快速检索找到候选项,重排序确保质量。
查询转换
在检索前转换用户查询以提高匹配效果:
- 查询扩展:添加相关术语或同义词
- 查询改写:重新表述以获得更好的语义匹配
- 多查询检索:生成多个查询变体并分别从每个变体检索
生产性能调优
缓存策略
缓存 Embedding 和查询结果以降低延迟和成本:
- Embedding 缓存:基于哈希查找存储重复文本的 Embedding
- 查询结果缓存:为相同或近乎相同的查询缓存检索结果
- 基于 TTL 的失效:当源数据变更时使缓存失效
分块优化
文档拆分方式影响检索质量:
- 固定大小分块:简单但可能拆分逻辑单元
- 语义分块:在自然边界处拆分(段落、章节)
- 重叠分块:添加重叠(10-20%)以在边界间保留上下文
经验法则:分块大小应匹配典型查询上下文需求。对于技术文档,每个分块 500-800 token 通常效果良好。
延迟优化
- 并行检索:并发查询多个索引或策略
- 近似最近邻(ANN):使用近似方法以轻微质量损失换取更快搜索
- 预过滤:在向量搜索前应用元数据过滤器以减少搜索空间
RAG 实现的常见陷阱
过度分块与分块不足
分块过小会丢失上下文;分块过大则引入噪声。从 500-1000 token 的分块开始,并根据检索质量迭代调整。
忽视元数据过滤
仅靠语义搜索是不够的。结合元数据过滤器(日期、作者、文档类型)将检索限制在相关子集内。
未评估检索质量
在样本查询上测量检索精确率和召回率。跟踪返回的文档是否真正回答了查询。没有评估,优化就是盲测。
Embedding 漂移
随着知识库增长,检索质量可能下降。安排定期重新 Embedding 或增量更新以维持质量。
常见问题:AI Agent 的语义搜索
如何在 Pinecone、Weaviate 和 Milvus 之间选择?
若追求托管简单性和可预测的扩展性,选择 Pinecone。若需要高级过滤和图能力,选择 Weaviate。若需要超大规模(数百亿向量)或多区域部署,选择 Milvus。三者均支持相同的核心操作;差异在于运维模式和高级功能。
为成本优化应使用多少维度的 Embedding?
从 768-1024 维开始以获得最佳质量-成本平衡。仅在存储或延迟至关重要时使用 384 维。将 1536+ 维保留给对准确性要求最高而成本次要的场景。
混合搜索是否值得额外复杂性?
对于处理多样化查询的生产系统,值得。混合搜索在精确匹配需求或领域特定术语方面持续优于纯密集检索。借助现代库,该复杂性是可以管理的。
多久应重新 Embedding 一次知识库?
更换 Embedding 模型、添加大量新内容或注意到检索质量下降时重新 Embedding。对于静态知识库,年度重新 Embedding 通常足够。对于动态内容,考虑增量更新。
密集检索与稀疏检索有什么区别?
密集检索使用向量相似度查找语义相关内容。稀疏检索(BM25/关键词)查找精确术语匹配。密集捕捉含义;稀疏捕捉精确度。两者结合可同时覆盖语义和字面匹配。
如何衡量 RAG 检索质量?
使用命中率指标(Top-K 结果中的相关文档比例)、MRR(平均倒数排名)和 NDCG(归一化折损累积增益)。创建一个带有预期相关文档的查询标注数据集,并随时间跟踪这些指标。
真实世界实施示例
理解理论是一回事;亲眼看到这些模式在实践中如何运作则是另一回事。以下是来自生产级 AI Agent 部署的具体示例。
示例 1:客户支持 Agent
一家 SaaS 公司使用语义搜索在其知识库上构建了客户支持 Agent。实施细节:
- 向量数据库:Pinecone,含 50 万产品文档向量
- Embedding 模型:text-embedding-3-small(1536 维)
- 分块策略:600 token 分块,100 token 重叠
- 检索:混合搜索,结合密集检索(前 20)与 BM25(前 10),由交叉编码器重排序
- 结果:首次接触解决率达 85%,而仅用关键词搜索时为 62%
示例 2:代码文档助手
一个工程团队创建了内部工具,帮助开发者查找相关代码模式和文档。关键决策:
- 向量数据库:在 Kubernetes 上自托管的 Milvus(1000 万+ 代码片段)
- Embedding 模型:在内部代码语料库上微调的自定义模型
- 元数据过滤:在语义搜索前按语言、项目和文件类型过滤
- 缓存:Redis 缓存常见查询,将 Embedding 成本降低 40%
- 结果:平均响应时间低于 200ms,开发者满意度提升 3 倍
评估框架
在部署任何 RAG 系统之前,建立评估框架。没有测量,优化就是猜测。
离线评估
创建一个保留的测试集,包含查询-文档对。对于每个查询,标记应检索哪些文档。然后测量:
- Recall@K:相关文档出现在前 K 个结果中的百分比?
- Precision@K:检索到的文档中有多少比例是相关的?
- 平均倒数排名(MRR):首个相关文档的倒数排名的平均值
- NDCG:归一化折损累积增益,考虑排名位置
在线评估
部署后,跟踪面向用户的指标:
- 响应质量评级:允许用户为 Agent 响应评分
- 引用准确性:检查引用的来源是否真正支持声明
- 相关查询率:用户修正查询的频率?
- 回答耗时:包括检索和生成在内的总延迟
生产系统的高级技巧
元数据感知检索
纯语义搜索会遗漏重要上下文。将向量相似度与结构化元数据过滤器结合:
- 时间过滤:对时间敏感查询优先显示近期文档
- 作者/来源过滤:提高权威来源的权重
- 分类路由:根据主题将查询路由到专用索引
新鲜度与漂移管理
知识库会随时间变化。实施以下策略:
- 增量更新:仅重新 Embedding 已变更的文档
- 新鲜度信号:在排序中对陈旧内容降权
- 版本跟踪:为维护历史查询保留多个版本
多模态搜索
对于处理文本和图像的 Agent,考虑多模态 Embedding:
- CLIP 模型:文本和图像的统一 Embedding
- 跨模态检索:用文本查询搜索图像,反之亦然
- 融合策略:在检索或排序阶段融合多模态
成本优化策略
生产级 RAG 系统可能产生显著持续成本。以下是优化方法:
| 成本领域 | 优化策略 | 潜在节省 |
|---|---|---|
| Embedding API 调用 | 缓存 Embedding、批量请求 | 60-80% |
| 向量数据库查询 | 近似搜索、维度缩减 | 40-60% |
| 交叉编码器重排序 | 仅对前 50 个使用,而非前 1000 个 | 50-70% |
| 存储成本 | 维度缩减、压缩 | 30-50% |
请记住:优化不应以牺牲检索质量为代价。在部署前,根据评估指标测试每项变更。
在 AI Agent 中开始语义搜索
构建有效的语义搜索需要在 Embedding 模型、检索策略和评估指标之间迭代。从一个托管向量数据库和标准 Embedding 开始,然后基于你的特定查询模式和质量要求进行优化。
对于需要可靠、生产级语义搜索的 AI Agent,考虑使用像 SmaugBrain 这样的平台,让平台处理基础设施复杂性,以便你专注于构建智能工作流。
相关文章::AI Agent RAG 实施指南 | AI Agent 记忆架构