
AI Agent状态管理:跨会话持久化与恢复Agent记忆
无状态Agent的问题
大多数AI Agent默认是无状态的。每次对话都从头开始,每次工具调用都是孤立的,当会话结束时,一切都会忘记。这对于简单的问答机器人来说没问题,但对于生产环境中的Agent来说完全行不通,它们需要记住用户偏好,在数小时或数天内保持任务进度,并在无需重来的情况下从故障中恢复。
状态管理是让Agent能够运行单一任务还是能够运行工作流之间的区别。没有它,您的Agent会在对话之间丢失上下文,重复已经完成的工作,并且无法优雅地处理故障。有了它,您的Agent将变得持久、可靠且真正自主。
本指南涵盖了在生产环境中管理Agent状态的实用模式——从简单的会话存储到复杂的分布式状态机。无论您正在构建需要记住工单历史的客户支持Agent、跟踪多文件更改的编码Agent,还是运行计划工作流的自动化Agent,这些模式都能保持您的Agent状态一致且可恢复。
为什么状态管理对生产Agent至关重要
Agent状态的三种类型
每个AI Agent都维护三种状态,每种状态都有不同的持久性要求:
| 状态类型 | 生命周期 | 示例 | 存储 |
|---|---|---|---|
| 会话状态 | 单次对话 | 当前任务,最近的对话轮次 | 内存中,短期 |
| 任务状态 | 工作流持续时间 | 步骤进度,工具输出 | 持久存储 |
| 用户状态 | 长期 | 偏好,历史记录,档案 | 数据库,用户存储 |
会话状态最容易管理,但也最脆弱。它仅存在于对话线程期间。当用户刷新页面或连接断开时,会话状态就会消失。对于简单的Agent来说,这是可以接受的。对于生产系统来说,这是一个可靠性风险。
任务状态可以跨越会话边界,但与特定工作流相关联。部署管道Agent需要记住哪些步骤已完成,哪些失败,以及创建了哪些资源。如果Agent在部署过程中崩溃,任务状态可以让它从中断的地方恢复,而不是重新开始。
用户状态是最有价值的。它捕捉了Agent对每个用户的了解——他们的偏好、过去的交互、学习到的模式。良好的用户状态使Agent随着时间推移感觉更个性化和智能。糟糕的用户状态会导致体验不一致和用户沮丧。
无状态管理的成本
如果没有适当的状态管理,Agent会遭受三种关键失败:
上下文丢失:Agent在任务中途忘记了它在做什么。用户必须重新解释所有内容,造成摩擦并增加token成本。
重复工作:Agent重复执行它已经完成的操作。编码Agent可能会重写它已经编辑过的文件,或者研究Agent可能会搜索它已经找到的信息。
恢复失败:当发生故障时,Agent没有办法恢复。用户必须从头开始,丢失所有进度,浪费时间与金钱。
这些故障会叠加。一个丢失上下文的Agent会生成更低质量的结果,这会导致更多错误,进而需要更多恢复尝试,从而进一步增加成本。打破这个循环需要故意的状态管理。
核心状态管理模式
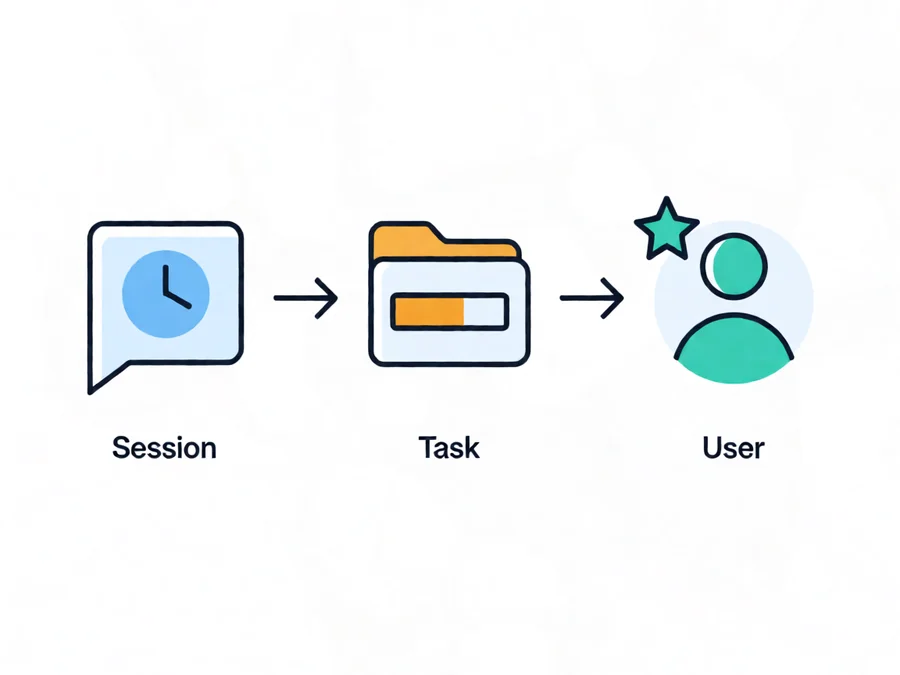
图1:具有不同保留策略的三种Agent状态类型
模式1:带TTL的基于会话的状态
最简单的方法:在内存中存储状态,并设置存活时间(TTL)过期。这对于会话短暂的单用户Agent来说效果很好,且状态丢失是可以接受的。
import time
from dataclasses import dataclass
from typing import Any, Optional

@dataclass
class SessionState:
    user_id: str
    created_at: float
    expires_at: float
    data: dict[str, Any]

    def is_expired(self) -> bool:
        return time.time() > self.expires_at

    def ttl_seconds(self) -> float:
        return max(0, self.expires_at - time.time())

class SessionStore:
    def __init__(self, default_ttl: int = 3600):
        self.sessions: dict[str, SessionState] = {}
        self.default_ttl = default_ttl

    def get(self, user_id: str) -> Optional[SessionState]:
        session = self.sessions.get(user_id)
        if session and session.is_expired():
            del self.sessions[user_id]
            return None
        return session

    def set(self, user_id: str, data: dict[str, Any]) -> SessionState:
        self.sessions[user_id] = SessionState(
            user_id=user_id,
            created_at=time.time(),
            expires_at=time.time() + self.default_ttl,
            data=data
        )
        return self.sessions[user_id]
适用场景:单用户聊天机器人、短暂工作流、开发环境。
避免使用场景:需要可靠性的生产系统、多用户部署、长时间运行的工作流。
模式2:带检查点的持久任务状态
对于跨越多个回合或会话的工作流,在每个重要操作后对Agent状态进行分阶段保存。这 Enables 从故障中恢复并恢复中断的任务。
import json
import uuid
from pathlib import Path

class TaskCheckpoint:
    def __init__(self, task_id: str, state: dict, metadata: dict = None):
        self.task_id = task_id
        self.checkpoint_id = str(uuid.uuid4())
        self.timestamp = time.time()
        self.state = state
        self.metadata = metadata or {}

    def to_dict(self) -> dict:
        return {
            "task_id": self.task_id,
            "checkpoint_id": self.checkpoint_id,
            "timestamp": self.timestamp,
            "state": self.state,
            "metadata": self.metadata
        }

    @classmethod
    def from_dict(cls, data: dict) -> 'TaskCheckpoint':
        return cls(
            task_id=data["task_id"],
            state=data["state"],
            metadata=data.get("metadata", {})
        )

class TaskStateManager:
    def __init__(self, storage_path: str = "./task_states"):
        self.storage = Path(storage_path)
        self.storage.mkdir(parents=True, exist_ok=True)

    def save_checkpoint(self, checkpoint: TaskCheckpoint) -> Path:
        filepath = self.storage / f"{checkpoint.task_id}.json"
        # 每个任务保留最近10个检查点
        checkpoints = self.load_checkpoints(checkpoint.task_id)
        checkpoints.append(checkpoint)
        checkpoints = checkpoints[-10:]

        with open(filepath, 'w') as f:
            json.dump([c.to_dict() for c in checkpoints], f, indent=2)
        return filepath

    def load_latest(self, task_id: str) -> Optional[TaskCheckpoint]:
        filepath = self.storage / f"{task_id}.json"
        if not filepath.exists():
            return None
        with open(filepath) as f:
            checkpoints = [TaskCheckpoint.from_dict(c) for c in json.load(f)]
        return checkpoints[-1] if checkpoints else None

    def load_checkpoints(self, task_id: str) -> list:
        filepath = self.storage / f"{task_id}.json"
        if not filepath.exists():
            return []
        with open(filepath) as f:
            return [TaskCheckpoint.from_dict(c) for c in json.load(f)]
适用场景:多步骤工作流、部署管道、长时间运行的任务。
关键优势:Agent可以从崩溃、网络故障和意外终止中恢复。
模式3:使用外部存储的分布式状态
对于服务于多个用户的生产环境Agent,使用外部存储(数据库、缓存、对象存储)来持久化状态。这 Enables 水平扩展和跨Agent实例的状态共享。
import redis
import json
from datetime import timedelta

class DistributedStateStore:
    def __init__(self, redis_url: str = "redis://localhost:6379"):
        self.redis = redis.Redis.from_url(redis_url)

    def get_session(self, session_id: str) -> dict:
        data = self.redis.get(f"agent:session:{session_id}")
        if data:
            return json.loads(data)
        return {}

    def set_session(self, session_id: str, data: dict, ttl: int = 3600):
        self.redis.setex(
            f"agent:session:{session_id}",
            ttl,
            json.dumps(data)
        )

    def get_user_profile(self, user_id: str) -> dict:
        data = self.redis.get(f"agent:user:{user_id}")
        if data:
            return json.loads(data)
        return {}

    def update_user_profile(self, user_id: str, updates: dict):
        key = f"agent:user:{user_id}"
        current = self.get_user_profile(user_id)
        current.update(updates)
        self.redis.set(key, json.dumps(current))

    def increment_counter(self, key: str, amount: int = 1) -> int:
        return self.redis.incr(key, amount)

    def acquire_lock(self, lock_id: str, ttl: int = 30) -> bool:
        return bool(self.redis.set(f"lock:{lock_id}", 1, nx=True, ex=ttl))

    def release_lock(self, lock_id: str):
        self.redis.delete(f"lock:{lock_id}")
适用场景:多用户生产系统、水平扩展、高可用性要求。
关键优势:状态在Agent重启后存活,随流量扩展,支持并发访问。
模式4:用于审计轨迹的事件溯源
对于处理敏感操作的Agent(金融交易、数据修改、合规工作流),使用事件溯源来保持所有状态更改的完整审计轨迹。
from datetime import datetime
from typing import List, Optional
import hashlib

class StateEvent:
    def __init__(self, event_id: str, event_type: str, timestamp: datetime,
                 payload: dict, signature: str = None):
        self.event_id = event_id
        self.event_type = event_type
        self.timestamp = timestamp
        self.payload = payload
        self.signature = signature or self._compute_signature()

    def _compute_signature(self) -> str:
        data = f"{self.event_id}{self.event_type}{self.timestamp.isoformat()}{json.dumps(self.payload, sort_keys=True)}"
        return hashlib.sha256(data.encode()).hexdigest()

    def verify(self) -> bool:
        computed = self._compute_signature()
        return self.signature == computed

class EventSourcedState:
    def __init__(self, store: DistributedStateStore, entity_id: str):
        self.store = store
        self.entity_id = entity_id
        self.events: List[StateEvent] = []
        self._load_events()

    def _load_events(self):
        raw_events = self.store.get_session(f"events:{self.entity_id}")
        self.events = [StateEvent(**e) for e in raw_events]

    def apply_event(self, event_type: str, payload: dict) -> StateEvent:
        event = StateEvent(
            event_id=str(len(self.events)),
            event_type=event_type,
            timestamp=datetime.utcnow(),
            payload=payload
        )
        self.events.append(event)
        self._persist_events()
        return event

    def _persist_events(self):
        self.store.set_session(
            f"events:{self.entity_id}",
            [e.__dict__ for e in self.events]
        )

    def get_state(self) -> dict:
        state = {}
        for event in self.events:
            if event.event_type == "initialized":
                state.update(event.payload)
            elif event.event_type == "updated":
                state.update(event.payload)
            elif event.event_type == "deleted":
                for key in event.payload:
                    state.pop(key, None)
        return state

    def get_history(self) -> List[dict]:
        return [e.__dict__ for e in self.events]
适用场景:需要合规的工作流、金融操作、审计关键系统。
关键优势:完整的审计轨迹、防篡改检测、从任何时间点重建状态。
实施清单
在生产环境部署状态管理之前,请验证:
- [ ] 会话持久性:状态在连接断开和页面刷新后存活
- [ ] TTL管理:过期的会话自动清理
- [ ] 检查点频率:检查点在重要的状态更改后发生
- [ ] 恢复测试:Agent在崩溃后成功从检查点恢复
- [ ] 状态验证:加载的状态在使用前通过完整性检查
- [ ] 并发控制:锁防止多实例部署中的竞态条件
- [ ] 存储限制:监控和限制状态大小
- [ ] 隐私合规:用户状态遵循数据保留和删除策略
- [ ] 备份策略:状态存储具备恢复程序
- [ ] 监控:记录状态操作并配置警报
常见陷阱及如何避免
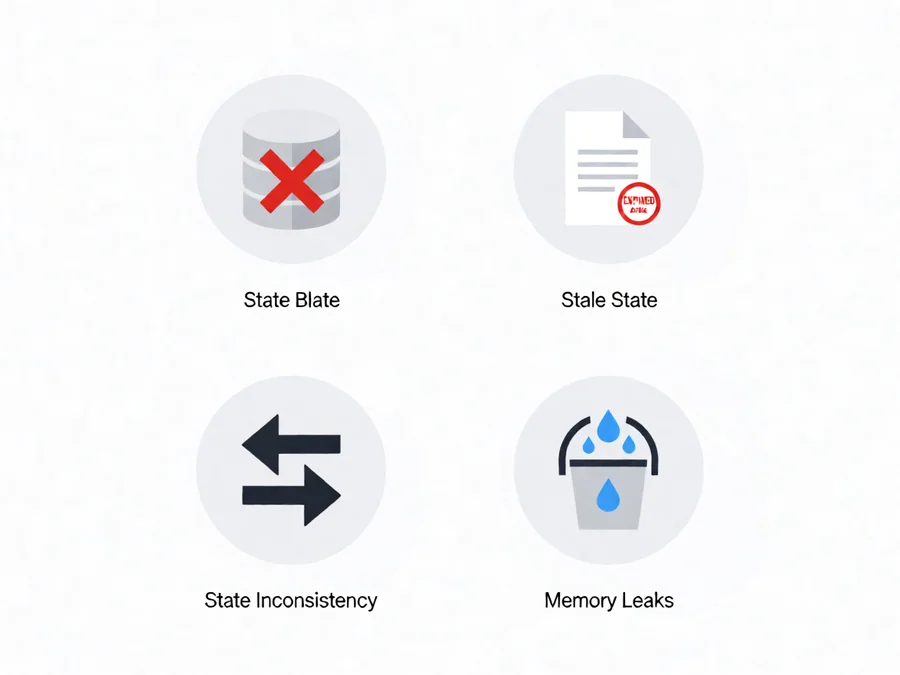
图2:Agent状态管理中的常见陷阱
陷阱1:状态膨胀
在状态中存储过多数据会导致性能下降和成本增加。状态的每个字节都会消耗内存,增加序列化时间,并减慢状态加载速度。
避免方法:
- 只存储必要的状态,不存储整个对话历史
- 在持久化之前压缩大型状态对象
- 对未使用或陈旧的数据实施状态修剪
- 对大型对象使用单独的存储(S3、数据库)
陷阱2:陈旧状态
当Agent不使缓存值失效或刷新时,状态会变得过时。这会导致Agent基于错误信息操作。
避免方法:
- 在状态变更时实施缓存失效
- 为缓存状态设置合理的TTL
- 使用版本号检测陈旧读取
- 记录状态新鲜度指标
陷阱3:状态不一致
当多个Agent实例并发更新状态时,竞态条件可能会导致数据不一致。一个实例会覆盖另一个实例的更改。
避免方法:
- 对关键状态更新使用分布式锁
- 使用版本号实现乐观并发
- 对复杂状态转换使用数据库事务
- 审核状态更改以检测冲突
陷阱4:内存泄漏
状态存储无限增长,随着时间推移消耗越来越多的内存和存储空间。
避免方法:
- 实施过期状态的自动清理
- 为每个用户/会话设置最大状态大小限制
- 将旧状态归档到更便宜的存储中
- 监控状态存储的增长率
现实世界示例
示例1:客户支持Agent
客户支持Agent需要记住工单历史、用户偏好以及在多次接触中的对话上下文。
状态设计:
- 会话状态:当前工单、活跃的对话轮次
- 任务状态:工单解决步骤、已执行的操作
- 用户状态:账户详情、偏好、过往工单
实现:
class SupportAgentState:
    def __init__(self, user_id: str, ticket_id: str):
        self.user_id = user_id
        self.ticket_id = ticket_id
        self.session = SessionStore()
        self.tasks = TaskStateManager()
        self.users = DistributedStateStore()

    def load_context(self) -> dict:
        # 加载所有状态层
        user_profile = self.users.get_user_profile(self.user_id)
        ticket_state = self.tasks.load_latest(self.ticket_id)
        session_data = self.session.get(self.session_id)

        return {
            "user": user_profile,
            "ticket": ticket_state,
            "session": session_data
        }
结果:Agent记住用户历史,从中断处继续,并提供个性化支持。
示例2:带文件跟踪的编码Agent
一个编码Agent在项目范围内编辑多个文件。它需要跟踪更改内容,撤销错误,并恢复中断的工作。
状态设计:
- 每次编辑前的文件快照
- 更改差异跟踪
- 编辑会话元数据
实现:
class CodeAgentState:
    def __init__(self, project_path: str):
        self.project_path = Path(project_path)
        self.snapshots = {}  # file_path -> snapshot_time
        self.edits = []  # 编辑操作列表
        self.checkpoint_dir = self.project_path / ".agent_checkpoints"

    def snapshot_file(self, file_path: str):
        filepath = Path(file_path)
        if filepath.exists():
            self.snapshots[str(filepath)] = {
                "content": filepath.read_text(),
                "timestamp": time.time()
            }

    def record_edit(self, file_path: str, old_content: str, new_content: str):
        self.edits.append({
            "file": file_path,
            "before": old_content,
            "after": new_content,
            "timestamp": time.time()
        })
        self._save_checkpoint()

    def revert_to_checkpoint(self, checkpoint_time: float):
        for edit in reversed(self.edits):
            if edit["timestamp"] <= checkpoint_time:
                break
            # 撤消此编辑
            filepath = Path(edit["file"])
            filepath.write_text(edit["before"])
        self.edits = [e for e in self.edits if e["timestamp"] <= checkpoint_time]
结果:Agent可以跟踪所有更改,撤销错误,并恢复中断的编辑。
示例3:部署管道Agent
一个Agent在多个环境之间编排CI/CD部署。它需要跟踪部署进度,处理回滚,并从故障中恢复。
状态设计:
- 部署状态机
- 环境状态跟踪
- 回滚历史
实现:
class DeploymentState:
    def __init__(self, deployment_id: str):
        self.deployment_id = deployment_id
        self.stages = ["build", "test", "staging", "production"]
        self.current_stage = 0
        self.stage_states = {}
        self.rolled_back = False

    def mark_stage_complete(self, stage: str, result: dict):
        self.stage_states[stage] = {
            "status": "completed",
            "result": result,
            "timestamp": time.time()
        }
        self.current_stage += 1

    def mark_stage_failed(self, stage: str, error: str):
        self.stage_states[stage] = {
            "status": "failed",
            "error": error,
            "timestamp": time.time()
        }
        self.save_checkpoint()

    def rollback(self):
        for stage in reversed(self.stages[:self.current_stage]):
            if stage in self.stage_states:
                self._execute_rollback(stage)
        self.rolled_back = True
        self.save_checkpoint()

    def save_checkpoint(self):
        checkpoint = TaskCheckpoint(
            task_id=self.deployment_id,
            state={
                "current_stage": self.current_stage,
                "stage_states": self.stage_states,
                "rolled_back": self.rolled_back
            }
        )
        task_manager.save_checkpoint(checkpoint)
结果:部署Agent可以跟踪进度,处理故障,并在需要时回滚。
与SmaugBrain集成
SmaugBrain的云端AI Agent平台提供了内置的状态管理能力:
- 自动会话持久化,支持可配置的TTL
- 任务检查点,在每个工具调用后自动保存
- 分布式状态存储,通过Redis集成实现
- 事件溯源审计轨迹,适用于合规工作流
- 自动状态恢复,在Agent重启后恢复状态
- 状态大小监控,并配备警报功能
对于生产部署,SmaugBrain处理状态管理的复杂性,让您专注于Agent逻辑和业务工作流。
常见问题
问:我该如何在选择基于会话的状态与持久状态之间做出选择?
答:对于短暂、单轮交互,请使用基于会话的状态。对于多轮工作流、任务跟踪以及任何需要从故障中恢复的场景,请使用持久状态。
问:我应该存储的最大状态大小是多少?
答:将会话状态保持在10KB以下,任务状态保持在100KB以下,用户状态保持在1MB以下。较大的状态应使用外部存储,并在状态对象中使用引用。
问:我应该多久对Agent状态进行一次检查点保存?
答:在每个重要的状态更改后(工具调用完成、做出决策、数据修改)进行保存。对于快速操作,每5-10秒批量保存一次检查点。
问:我可以将状态管理与Serverless Agent一起使用吗?
答:可以,但请使用外部存储(Redis、数据库)而不是内存状态。Serverless函数在调用之间不会持久化。
问:升级Agent版本时,我该如何处理状态迁移?
答:为您的状态模式添加版本,并实现迁移函数。在应用于生产环境之前,先在复制的状态上测试迁移。
问:保护敏感状态的最佳方式是什么?
答:加密静态状态,使用HTTPS传输状态,实施访问控制,并遵循数据保留策略。切勿明文存储凭据。
问:我该如何测试状态管理行为?
答:在状态更改后模拟崩溃,验证从检查点恢复的能力,测试并发访问,并验证中断后的状态一致性。
关键要点
- 状态管理将实验性Agent与生产Agent区分开来——对于可靠系统来说,它不是可选的
- 三种状态类型需要不同的处理方式:会话(短暂)、任务(持久)、用户(长期)
- 检查点 Enables 恢复——Agent可以从故障中恢复而不会丢失进度
- 外部存储 Enables 扩展——分布式状态存储支持多个Agent实例
- 事件溯源提供审计轨迹——对于合规和调试至关重要
- 监控状态健康——跟踪大小、新鲜度和一致性,以便尽早发现问题
- 测试故障场景——在实际生产环境中依赖之前,验证恢复功能
有效的状态管理将AI Agent从脆弱的实验转变为可靠的生产系统。本指南中的模式为您的SmaugBrain部署中实现强大的状态策略提供了实用的路线图。
准备好构建生产级AI Agent了吗? [探索SmaugBrain](https://www.smaugbrain.com/) —— 云端AI Agent平台,具备内置状态管理、自动检查点和分布式持久化,适用于可靠自主工作流。