
AI Agent决策智能:如何在自主系统中做出更明智的选择
每个AI Agent都面临一个根本性挑战:如何在复杂且不确定的环境中做出最优决策。是探索新策略还是利用已知策略?是立即行动还是收集更多信息?答案取决于任务性质、错误成本以及信息价值。
本指南探讨AI Agent的决策智能——帮助自主系统做出明智选择的框架、算法和实践模式。我们将涵盖探索与利用的权衡、决策树、效用理论、多臂老虎机以及生产系统中使用的实际实施模式。
为什么决策智能对AI Agent至关重要
与遵循确定性规则的传统软件不同,AI Agent必须在不确定性下做出决策。它们面临信息不完整、目标冲突和时间压力。良好的决策能力是将可靠实现目标的Agent与浪费资源或犯下灾难性错误的Agent区分开来的关键。
决策智能融合了运筹学、机器学习和认知科学的洞见,以构建能够:
- 平衡探索与利用——尝试新方法与使用成熟策略
- 量化不确定性——理解何时信息不足以做出决策
- 评估权衡——权衡速度与准确性、成本与质量
- 从结果中学习——通过反馈循环持续改进决策能力
探索与利用的困境
探索与利用的权衡是Agent决策中的核心挑战。Agent必须决定是否:
利用:使用已知信息以最大化即时奖励。如果Agent发现操作A平均可获得10分,利用意味着反复选择操作A。
探索:尝试未知操作以收集信息。即使操作B当前看起来更差,探索它可能会揭示值得追求的隐藏机会。
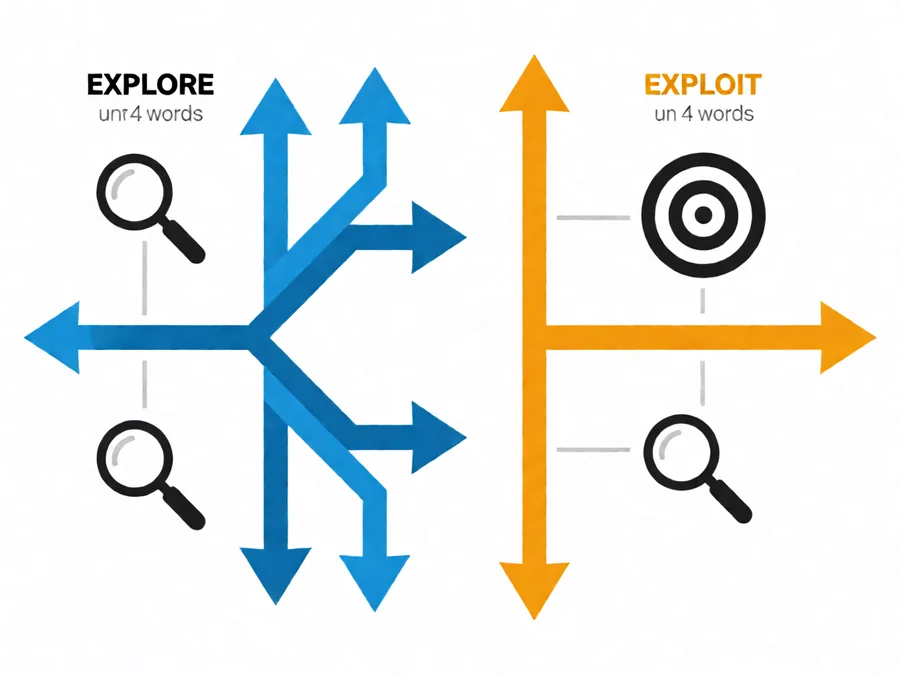
何时探索 vs 何时利用
最优平衡取决于多个因素:
- 时间范围:具有长期目标的Agent应更多探索;短期Agent应更多利用
- 探索成本:高成本探索需要更强的理由
- 不确定性水平:高不确定性有利于探索
- 竞争环境:在竞争性环境中,探索可能提供战略优势
AI Agent的决策框架
多臂老虎机
多臂老虎机问题建模了Agent必须在多个选项(臂)之间做出选择的场景,每个选项具有未知的奖励分布。经典例子是赌场的老虎机,赌客决定拉哪个拉杆。
常见算法:
- ε-贪婪(Epsilon-greedy):大多数时候选择已知最佳操作,但以概率ε随机探索
- 置信上界(UCB):根据置信区间选择具有高潜力的操作
- 贝叶斯方法:维护各臂质量的概率分布,并通过观测结果进行更新
马尔可夫决策过程
马尔可夫决策过程(MDP)为结果部分随机、部分由Agent控制的决策场景提供了数学框架。MDP是强化学习和序列决策的基础。
关键组件:
| 组件 | 描述 | 示例 |
|---|---|---|
| 状态(S) | 所有可能的情境 | 位置、库存水平、系统状态 |
| 动作(A) | 可用决策 | 移动、工具调用、查询 |
| 转移(P) | 状态变化的概率 | 成功率、故障模式 |
| 奖励(R) | 即时反馈 | 积分、成本、用户满意度 |
决策树
决策树提供了可解释的框架,用于映射选择、结果和概率。当Agent需要解释其推理过程,或决策涉及清晰的分支逻辑时,它们特别有用。
构建高效决策树:
- 从根决策节点开始(需要做出的选择)
- 向外分支到机会节点(不确定结果)和决策节点(进一步选择)
- 为不确定分支分配概率
- 计算每个节点的期望值
效用理论与基于价值的决策
效用理论提供了表示偏好和做出理性决策的形式化方式。Agent不是比较原始奖励,而是根据期望程度为结果分配效用量。
核心原则:
- 完备性:Agent可以比较任意两个结果
- 传递性:如果A优于B,且B优于C,则A优于C
- 连续性:每个结果都存在效用量
- 可替代性:赌局可通过期望效用进行比较
实际应用:当Agent面对相互竞争的目标(速度vs准确性、成本vs质量)时,效用函数有助于量化权衡。例如,客户服务Agent可能将响应时间权重设为0.6,准确性权重设为0.4,从而组合成单一决策分数。
Agent决策中的风险管理
并非所有决策都承担同等风险。Agent应根据涉及的风险程度调整其信心和谨慎度。
风险厌恶 vs 风险寻求策略
风险厌恶型Agent倾向于确定性的结果而非赌博,即使赌博具有更高的期望值。这种方法适用于损失具有灾难性后果的场景(金融交易、医疗诊断)。
风险寻求型Agent为潜在的更高奖励接受波动性。这种方法适用于探索可能带来突破性改进的场景(研发、创新任务)。
风险中性Agent在不调整的情况下最大化期望值。这是许多优化框架的默认假设。
实现风险意识
Agent可以通过以下方式融入风险管理:
- 风险价值(VaR):限制严重损失的概率
- 条件风险价值(CVaR):优化在VaR被超越情况下的预期损失
- 鲁棒优化:在不确定性边界内为最坏情况做好准备
- 信息价值:计算收集更多数据是否值得相应的延迟
实际应用模式
模式一:基于阈值的决策
为不同类型的行动设置置信度阈值:
| 行动类型 | 置信度阈值 | 行为 |
|---|---|---|
| 关键执行 | > 0.95 | 仅在高度确信时行动 |
| 重要决策 | > 0.80 | 低于阈值时默认升级至人工 |
| 低风险实验 | > 0.60 | 允许更广泛的探索 |
模式二:自适应探索
基于不确定性的动态探索:
- 高不确定性:提高探索率(ε = 0.3)
- 中等不确定性:适度探索(ε = 0.1)
- 低不确定性:主要利用(ε = 0.01)
模式三:分层决策
将复杂决策分解为多个层次:
- 战略层:长期目标和资源分配
- 战术层:中期规划和流程设计
- 操作层:即时行动和工具执行
常见陷阱及避免方法
陷阱一:过度拟合近期历史
过度加权近期经验的Agent可能会错过长期模式。解决方案:使用指数移动平均或缓冲式记忆,平衡近期性与稳定性。
陷阱二:忽视机会成本
选择一个行动意味着放弃其他行动。Agent应考虑它们放弃的是什么,而不仅仅是获得什么。解决方案:在行动值之外维护机会成本估计。
陷阱三:确认偏误
Agent可能会寻找支持已有信念的信息。解决方案:主动查询反驳证据,并对矛盾数据给予适当权重。
陷阱四:分析瘫痪
花费过多时间在决策上会延误行动并错失机会。解决方案:实施停止规则,在有限 deliberation 后强制做出决策。
评估决策质量
如何判断Agent是否在做出良好决策?跟踪以下指标:
- 结果准确性:决策导致预期结果的频率
- 资源效率:每次决策的成本(计算、时间、token)
- 适应速度:Agent从反馈中学习的速度
- 错误恢复:纠正错误决策的能力
常见问题:AI Agent决策智能
如何选择探索与利用?
使用UCB算法实现平衡探索,或使用基于不确定性水平的自适应ε的ε-贪婪算法。在生产环境中,从较高的探索率开始(ε = 0.2),并随着信心建立而逐渐衰减。
MDP与决策树有什么区别?
MDP处理具有概率转移的序列决策,使用动态规划求解。决策树是对选择和结果的静态表示,更适合一次性决策或当可解释性比优化更重要的场景。
如何处理Agent决策中的冲突目标?
为每个目标分配权重并计算加权效用。或者,使用帕累托优化寻找无法在不恶化另一目标的情况下改进某一目标的解决方案。对于简单情况,选择主要目标并将其他目标作为硬性约束。
Agent何时应该向人类寻求帮助?
在以下情况下请求人工干预:置信度低于阈值、风险较高、情境新颖,或存在多个有效选项且权衡不明确。否则,让Agent自主决策以保持效率。
如何防止Agent过于保守?
降低探索性行动的置信度阈值,添加内在动机(新奇奖励),或使用乐观初始化,假设所有行动可能都有价值,除非被证明否则。
模拟在Agent决策中的作用是什么?
模拟让Agent可以在没有现实后果的情况下练习决策。使用蒙特卡洛模拟来估计结果分布,或构建世界模型来预测后果。对于高成本或危险的决策,模拟尤其有价值。
开始使用决策智能
从简单开始:使用少量关键行动实现ε-贪婪探索。随着Agent学习决策环境,逐步增加复杂性。记住,良好的决策是迭代的——监控结果、更新模型,并随着时间的推移 refine 策略。
对于生产级决策智能,请考虑SmaugBrain等平台,它们提供内置的探索策略、不确定性量化和自适应决策框架。
相关文章:AI Agent重试策略 | AI Agent审批工作流