
AI Agent性能优化:基准测试、延迟降低与吞吐量扩展
AI智能体功能强大,但性能至关重要。一个缓慢的智能体会消耗更多token费用、令用户沮丧,并在负载下崩溃。无论你运行一个还是上千个智能体,优化不是一种选择,而是生产环境的纪律要求。
本指南涵盖需要衡量什么、如何降低延迟以及如何在保持可靠性的同时扩展吞吐量。你会发现实用的模式,而非空洞的理论。
优化前需要衡量什么
没有测量的性能优化就是猜测。在改变任何东西之前,先为重要的指标建立基线。
需要跟踪的关键指标
| 指标 | 为何重要 | 如何衡量 |
|---|---|---|
| 首token时间(TTFT) | 用户感知的延迟 | 记录从请求到第一个token的时间戳 |
| 每秒token数(TPS) | 吞吐量效率 | 在时间窗口内跟踪token输出 |
| 端到端延迟 | 总任务完成时间 | 从用户输入到最终输出进行测量 |
| 错误率 | 可靠性信号 | 跟踪4xx/5xx响应和超时 |
| 每次任务成本 | 业务影响 | token用量乘以定价求和 |
| 队列深度 | 拥塞指示器 | 监控飞行中的待定请求 |
基础监控
在智能体管道中添加计时中间件。记录每个阶段:
- 输入验证和预处理
- 工具选择和执行
- LLM推理调用
- 输出解析和格式化
- 响应序列化
起初你不需要昂贵的APM工具。带有时间戳的简单结构化日志比直觉更快揭示瓶颈。
降低延迟:快速路径
延迟会摧毁用户信任。每一秒等待都会增加流失率。以下是经过验证的缩短响应时间的技术。
1. 尽早流式传输响应
不要等到完整响应完成后才将数据发送给用户。token到达时就流式传输它们。这让智能体即使在总完成时间很长的情况下也能感觉响应迅速。
async for chunk in llm.stream(prompt):
    yield chunk.token
    yield chunk.delta
流式传输将感知延迟从完成时间转移到首token时间。用户立即看到进度。
2. 缓存重复查询
许多智能体请求是重复的。对相同或几乎相同的输入缓存结果。使用语义缓存匹配意图相似的查询,而不仅仅是精确字符串匹配。
缓存分层在实践中效果良好:
- 热缓存:用于最频繁查询的内存存储(TTL 5-15分钟)
- 温缓存:Redis或其他用于近期查询(TTL 1-24小时)
- 冷缓存:数据库或向量存储用于历史查询(无TTL,已索引)
3. 减少工具调用开销
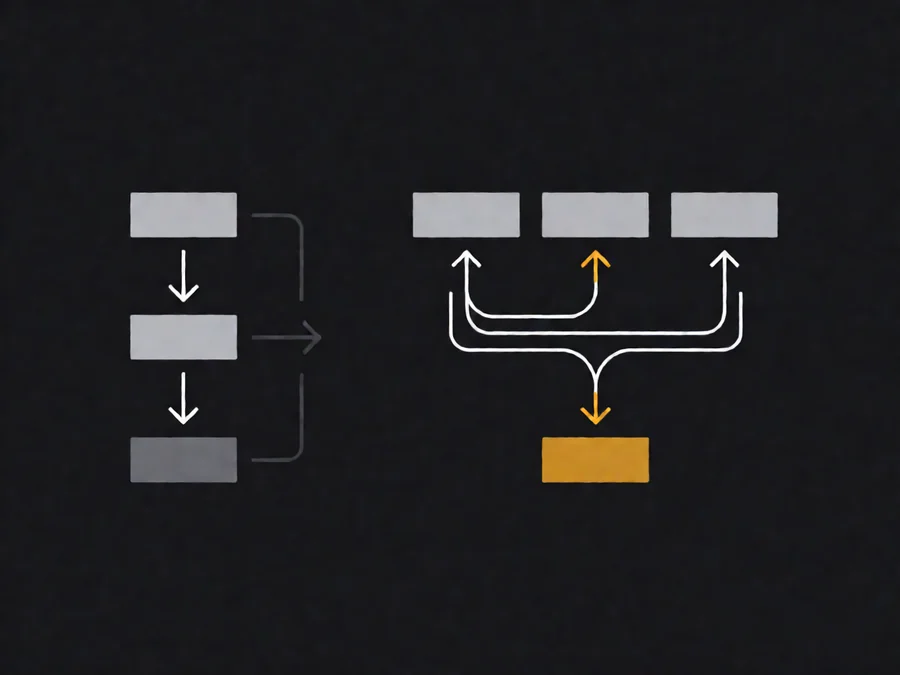
每次工具调用都会增加延迟。批量处理独立操作。尽可能并行化。
不要顺序调用三个工具:
tool_call_1 → result → tool_call_2 → result → tool_call_3 → result当依赖关系允许时并行调用:
tool_call_1 ──┐
tool_call_2 ──┼→ 合并结果
tool_call_3 ──┘
条件式工具调用也有帮助。只有当智能体确定需要时才调用工具,而不是每轮都调用。
4. 优化提示词长度
更长的提示词花费更多且处理时间更长。删除不必要的上下文。使用检索增强生成仅获取相关信息,而不是一开始就加载所有内容。
技术:
- 分块文档并仅检索相关部分
- 将长对话摘要为简洁的上下文
- 使用系统提示词存放静态指令,而非动态数据
- 为长时间会话实现提示词压缩
5. 简单任务使用更快的模型
并非每个请求都需要你最好的模型。将简单查询路由到更小、更快的模型。将大模型保留给复杂推理。
一个实用的路由策略:
- 快速层:小模型(响应不超过1秒),用于分类、简单问答、路由决策
- 标准层:中等模型用于大多数任务
- 重型层:大模型用于复杂推理、代码生成、多步骤规划
衡量各层级之间的质量差异。很多时候,小模型在常规任务中的表现已达到可接受水平。
扩展吞吐量:处理更多请求
延迟优化帮助单个请求。吞吐量扩展帮助你的系统同时处理更多请求。
并发控制
为并发智能体执行设置明确限制。无限并发会导致资源耗尽、级联故障,并降低所有用户的性能。
实现:
- 基于信号量的并发:将并行LLM调用限制在安全上限
- 请求排队:通过公平调度缓冲多余请求
- 优先级:关键请求插队;低优先级请求等待
速率限制策略
速率限制保护你的基础设施并确保公平使用。在多个级别应用限制:
| 级别 | 限制类型 | 目的 |
|---|---|---|
| 按用户 | 每分钟请求数 | 防止滥用,确保公平 |
| 按智能体 | 并发执行数 | 保护后端资源 |
| 按模型 | 每分钟token数 | 管理LLM提供商成本 |
| 全局 | 系统总吞吐量 | 保持服务稳定性 |
对智能体进行负载测试
在扩展到生产环境之前,用负载测试验证你的假设。合成流量会暴露真实使用可能遗漏的瓶颈。
测试场景:
- 基准负载:正常预期流量量级
- 峰值负载:短期内2-3倍预期流量
- 压力测试:逐渐增加负载直到失败
- 浸泡测试:持续数小时的负载以检测内存泄漏
跟踪每种场景下延迟、错误率和资源使用的变化。记录临界点。
水平扩展模式
当单个实例无法处理负载时,进行水平扩展。常见模式:
- 无状态工作池:每个智能体实例独立处理请求
- 分片状态:在多个存储之间分布对话状态
- 主从路由:将相似的查询定向到同一实例以实现缓存局部性
- 自动伸缩组:根据队列深度或延迟动态添加实例
无状态设计最容易扩展。尽量减少共享状态。使用外部存储来处理对话和缓存。
性能优化中的常见陷阱
即使是经验丰富的团队也会犯同样的错误。避免这些。
优化错误的东西
分析揭示时间实际上花在哪里。没有分析,你基于假设进行优化。不要假设任何东西。先测量。
一个常见模式:开发者优化LLM调用速度,而瓶颈实际上是等待外部API的I/O。修复真正的瓶颈。
缓存一切
缓存听起来不错,直到你缓存了过期或敏感数据。实现缓存失效策略。设置适当的TTL。永远不要在没有加密的情况下缓存个人数据或财务信息。
忽视负载下的错误处理
性能降级是有梯度的,直到突然崩溃。为故障设计系统。实现熔断器、回退响应和优雅降级。一个缓慢但正确的答案比一个快速但错误的要好。
过度工程化解决方案
从简单开始。只有在有证据表明它有帮助时才添加缓存。只有在测量质量差异后才实现复杂的路由。过早优化浪费时间并增加复杂性。
实际案例
案例1:电商客服智能体
一家电商公司运行一个回答客户关于订单、退货和产品问题的智能体。初始性能:
- 平均响应时间:8.2秒
- 峰值负载能力:15个并发用户
- 每次对话成本:$0.45
优化后:
- 平均响应时间:2.1秒(减少74%)
- 峰值负载能力:150个并发用户(提升10倍)
- 每次对话成本:$0.12(减少73%)
关键改进:
- 添加流式传输以获得即时反馈
- 为产品FAQ实现语义缓存
- 将简单查询路由到小模型
- 批量处理订单状态查询
- 通过摘要对话历史减少提示词长度
案例2:代码审查智能体
一个开发团队使用智能体审查pull request。初始性能:
- 分析时间:每次PR 45秒
- 并发负载下错误率:12%
- 月成本:$2,400
优化后:
- 分析时间:每次PR 12秒(减少73%)
- 并发负载下错误率:2%
- 月成本:$680
关键改进:
- 并行化处理文件而非顺序处理
- 为未更改的文件缓存分析结果
- 语法检查使用小模型,仅语义分析使用大模型
- 实现请求排队,为关键PR设置优先级
实施检查清单
使用此清单系统化你的优化工作。
- [ ] 使用时间戳对所有智能体阶段进行监控
- [ ] 为延迟、吞吐量和成本建立基线指标
- [ ] 从分析数据中识别前三个瓶颈
- [ ] 实现流式传输以实现首token响应
- [ ] 为重复查询添加语义缓存
- [ ] 并行化独立工具调用
- [ ] 基于任务复杂度实现模型路由
- [ ] 设置并发限制和请求队列
- [ ] 在多个级别添加速率限制
- [ ] 运行负载测试以验证容量
- [ ] 记录临界点和恢复流程
- [ ] 部署后持续监控性能
常见问题
我如何知道我的智能体足够快?
没有通用的阈值。研究你的用户。如果他们在完成之前放弃会话,说明你的智能体太慢了。常见目标:
- 首token低于1秒
- 简单任务完成响应低于5秒
- 复杂任务完成响应低于15秒
我可以同时优化成本与性能吗?
可以,但不总是线性的。两者都有帮助的策略:
- 流式传输在不改变实际吞吐量的情况下减少感知延迟
- 缓存同时减少延迟和token成本
- 模型路由将简单任务发送给更便宜、更快的模型
需要权衡的策略:
- 更大的模型提高质量但增加成本和延迟
- 更激进的缓存改善延迟但可能提供过期数据
缓存到底有多大帮助?
取决于查询重复率。在客户支持场景中,30-60%的查询在几小时内重复。对于这些重复模式,语义缓存可以减少40-70%的LLM调用。
在创意或唯一请求场景中,缓存的帮助较小。在大量投资之前先测量你的重复率。
团队在扩展智能体时犯的最大错误是什么?
在没有设置限制的情况下运行太多并发执行。这会压垮LLM提供商,使成本呈指数级增长,并降低所有用户的延迟。始终设置并发上限并监控队列深度。
我应该使用多个模型还是只有一个?
当查询复杂度差异显著时,多个模型会有帮助。如果你的所有请求复杂度相似,一个精心调优的模型可能就足够了。在确定路由策略之前,先衡量不同模型之间的质量差异。
结论
性能优化是迭代的过程。从测量开始。识别瓶颈。一次实施一项更改。跟踪结果。重复进行。
本指南中的技术——流式传输、缓存、并行化、模型路由和并发控制——解决了最常见的性能问题。系统地应用它们。记录适合你特定用例的方法。
你的用户会注意到差异。你的成本会下降。你的系统能够扩展。
更多关于构建生产就绪AI智能体的指南,请访问 https://www.smaugbrain.com/。