
# AI Agent 错误处理与重试策略:生产环境指南
引言
在开发环境中运行完美、在生产环境中却不可预测地崩溃的 AI Agent,是一种非常常见的模式。原型系统与生产系统之间的差异往往不在于智能——而在于韧性。错误是不可避免的:LLM API 会对您进行限流,网络连接会中断,下游服务会返回意外负载,工具执行中途超时。如果没有系统的错误处理机制,这些临时故障会级联为工作流失败、重复操作和用户沮丧。
本指南介绍适用于生产环境的 AI Agent 错误处理与重试策略。您将学习如何正确分类错误、实现带指数退避的有界重试、使用幂等密钥防止重复、设计回退链以及应用熔断器。
为何 AI Agent 的错误处理有所不同
传统软件错误处理遵循可预测的路径。HTTP 请求返回您可以分支判断的状态码。AI Agent 的运行方式不同,因为其执行流程是动态的,由语言模型决策驱动而非静态控制流。
三个特性使 Agent 错误处理变得尤为困难:
非确定性执行路径。相同的输入可能在不同运行中产生不同的工具调用序列。重试策略必须处理每一个可能的故障点,而不仅是一组固定的分支。
有状态副作用。与纯函数不同,Agent 会修改外部状态——发送邮件、更新数据库、触发付款。如果原始操作已成功但响应丢失,盲目重试可能导致这些效果的重复执行。
不透明的故障模式。LLM 可能返回格式错误的 JSON 响应、跳过必需的工具调用或幻化参数。这些是逻辑错误而非传输错误,需要不同的恢复策略。
生产型 Agent 需要分层防御:针对基础设施故障的系统级重试、针对模糊结果的验证后重试,以及针对推理错误的模型感知恢复。
在实施重试之前先对错误进行分类
Agent 错误处理中最常见的错误是将所有故障一视同仁。重试认证错误会浪费 token,而不重试速率限制则会不必要地丢失工作。分类发生在三个层级。
传输层错误
传输层错误发生在应用程序逻辑执行之前。包括连接超时、DNS 解析失败和 TCP 连接中断。这些几乎都是临时的。
| 错误类型 | 是否重试 | 策略 |
|---|---|---|
| 连接被拒绝 | 是 | 指数退避,3–5 次尝试 |
| 超时 | 是 | 较短的退避上限(10–30秒) |
| DNS 失败 | 有条件 | 5 秒后重试一次 |
| TLS 错误 | 否 | 快速失败;需要手动干预 |
传输层重试属于编排层。LLM 不应看到这些错误——系统应静默处理它们。
服务层错误
服务层错误来自可达端点但拒绝了请求的情况。这些需要检查 HTTP 状态码。
| 状态码 | 是否重试 | 策略 |
|---|---|---|
| 429 | 是 | 解析 Retry-After 头部;相应退避 |
| 500 | 有条件 | 带退避重试一次;耗尽后升级 |
| 502/503 | 是 | 标准指数退避 |
| 400 | 否 | 修复参数;不要重试相同请求 |
| 401/403 | 否 | 快速失败;凭证需要轮换 |
速率限制响应值得特别关注。现代 LLM 提供商包含 Retry-After 头部。始终优先采用提供商的指导建议而非通用退避计算。
应用层错误
应用层错误源自 Agent 自身的逻辑:无效的工具参数、缺失必填字段或格式错误的模型输出。这些很少能通过重试恢复。相反,它们需要将结构化错误报告回模型,以便其调整方法。
当发生应用层错误时,将其作为清晰文本回答。如果搜索工具收到空查询,应返回 "Search requires a non-empty query string" 而不是抛出未处理的异常。Agent 可以看到错误上下文并重新格式化请求。
带指数退避和抖动的有界重试
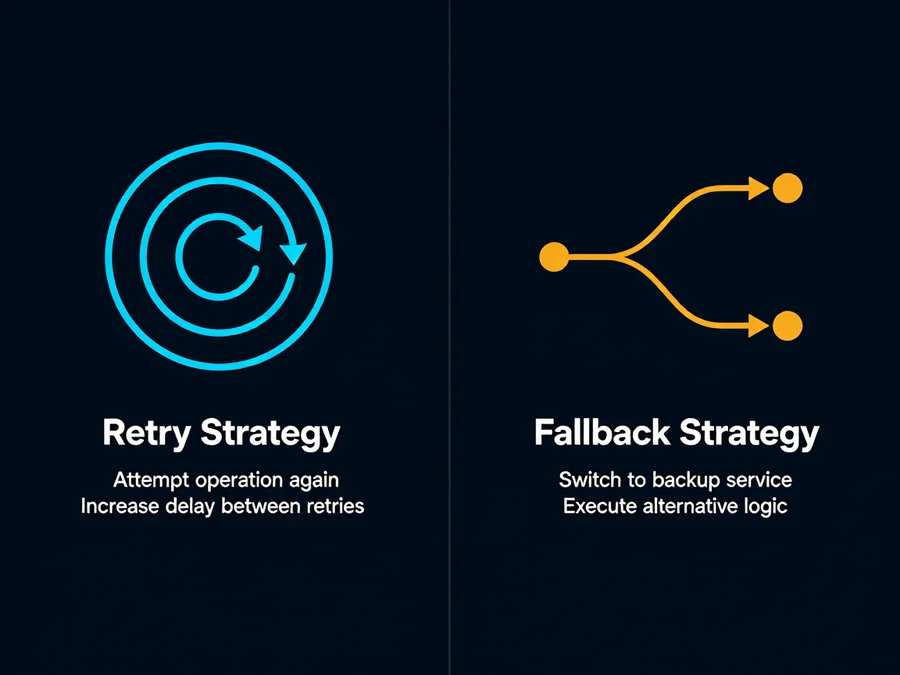
指数退避是生产环境重试逻辑的基础。您在每次尝试之间等待越来越长的间隔,让过载的服务有时间恢复。
标准公式:
delay = initial_delay × backoff_factor^attempt当 initial_delay = 1s 且 backoff_factor = 2 时,四次尝试的重试会产生 1s、2s、4s 和 8s 的延迟——总等待时间为 15 秒。
裸指数退避会导致雷群效应:许多 Agent 在故障后同时重试,它们会在同一时刻醒来并淹没正在恢复的服务。解决方案是抖动——向每次延迟添加随机变化。
import random, time

def delayed_retry(max_attempts, initial_delay=1.0, backoff_factor=2.0, max_delay=60.0):
    for attempt in range(max_attempts):
        try:
            return execute_operation()
        except TransientError as e:
            if attempt == max_attempts - 1:
                raise
            delay = min(initial_delay * (backoff_factor ** attempt), max_delay)
            sleep_time = random.uniform(0, delay)
            time.sleep(sleep_time)
有界重试必须有硬限制。根据延迟容忍度设置 max_attempts——面向用户的操作通常为 3 到 5 次。记录每一次重试尝试,包括错误类型、尝试次数和计算的延迟。
幂等密钥:让重试安全可控
只有当操作具有幂等性时,重试才是安全的——即多次执行的结果与执行一次相同。大多数写操作天然不具备幂等性。
幂等密钥将确定性标识符与每个逻辑操作关联起来。当下游服务两次接收到相同的密钥时,它返回缓存结果而非再次执行操作。
import hashlib

def make_idempotency_key(agent_id, operation_type, payload):
    material = f"{agent_id}\x00{operation_type}\x00{payload}"
    return hashlib.sha256(material.encode()).hexdigest()[:32]
密钥生成规则:
当下游 API 不支持原生幂等密钥时,实现客户端幂等存储。按标识符缓存每次成功操作的结果。重试时,先检查缓存。
验证后重试:解决模糊结果
最困难的故障模式是模糊结果:Agent 发送了工具请求、收到超时,却无法得知操作是否实际执行。盲目重试会导致重复,验证后重试可避免这一问题。
验证后重试模式增加了一个后置条件检查:
1. 使用幂等密钥执行操作。
2. 如果响应指示成功,正常继续。
3. 如果响应是错误或超时,查询当前状态以验证预期效果是否存在。
4. 如果验证确认成功,将操作视为已完成。
5. 如果验证确认失败,使用相同的幂等密钥重试。
这对应于分布式系统中带有幂等消费者的至少一次投递原则。对于中间序列失败留下部分状态的复合操作,验证尤为重要。从未验证的点恢复,而不是重试所有内容。
持久失败的降级链
当重试耗尽时,Agent 需要一条降级路径。降级分为两类。
工具级降级将一个实现替换为另一个:主/备工具、缓存结果,或在复杂调用反复失败时使用简化操作。
模型级降级解决推理层失败:同提供商等级切换、跨提供商故障转移,或对关键路径使用本地/离线降级。
降级配置应当明确且可测试。定期运行模拟提供商宕机的混沌测试。不要在真实事故中才发现降级失败。
熔断器:保护系统免受自身伤害
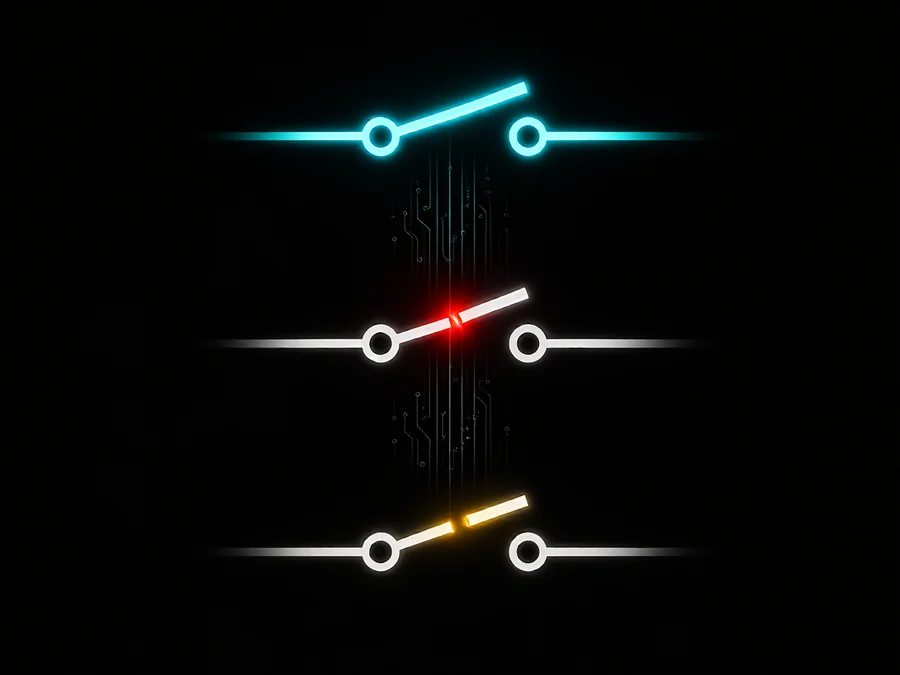
熔断器防止对已退化服务的持续调用。当连续失败超过阈值时,断路器打开并在冷却期内短路后续请求。
熔断器有三个状态:
关闭。正常运行。每次错误时故障计数递增。
打开。立即拒绝请求。计时器跟踪冷却期。
半开。冷却期后,一个探测请求通过。成功则关闭熔断器;失败则重新打开。
按依赖项配置熔断器。您的 Agent 可能调用五个不同的工具——每个工具有不同的可靠性特征。支付网关故障应立即触发熔断;非关键的分析工具可以容忍更多失败。
熔断器与重试逻辑互补。在单次调用内对临时错误使用重试,用熔断器停止对持续损坏依赖的反复尝试。
模型层面的错误恢复
系统级重试处理基础设施故障。Agent 还会遇到模型引发的故障:幻化工具参数、跳过步骤、循环推理或计划执行错误。
结构化错误反馈。将错误作为模型可以解析的清晰文本返回。包含工具名称、验证失败和预期格式提示。
有界反思循环。某些框架允许 Agent 在失败后修订其方法。强制执行最大修订周期数——通常为 2–3 次。耗尽后升级到预定义处理器。
人工升级路径。并非所有失败都能自动化处理。升级应包括任务摘要、具体错误、已尝试的恢复操作、可用的人工选项和唯一参考 ID。
实战示例:构建弹性研究 Agent
考虑一个使用三个工具的 AI Agent 来研究市场趋势:网页搜索 API、新闻聚合 API 和报告生成器。
搜索层。每次搜索使用全抖动指数退避的有界重试(3 次尝试,1 秒初始,2.0 因子,30 秒最大值)。搜索 API 在速率限制时返回 429——重试逻辑解析 `Retry-After` 头部。如果所有搜索都耗尽重试,Agent 继续使用收集到的结果而非整体失败。
新闻层。熔断器监控 502 频率。连续 5 次 502 后,熔断器打开 60 秒。在打开状态下,使用带有新鲜度时间戳的缓存新闻结果。
报告层。每次写入都携带由 Agent 会话 ID 和报告标题派生的幂等密钥。如果写入超时,Agent 在重试前验证报告是否已保存。客户端缓存存储最近的写入结果。
模型层。如果综合产出格式错误的输出,Agent 收到结构化验证反馈并以修正后的指令重新生成。反思计数器将重新生成限制为 2 次尝试。
这种分层方法意味着单个工具的故障会优雅降级而非导致管道崩溃。
常见陷阱
陷阱 1:重试不可重试的错误。将所有异常同等对待会在认证失败上浪费 token,并在验证错误上造成无限循环。显式分类错误。
陷阱 2:非确定性幂等密钥。为每次重试生成新的 UUID 会破坏去重功能。从稳定输入派生密钥。
陷阱 3:对变更操作无验证地重试。假设失败的请求从未执行是导致重复付款和数据损坏的最快途径。始终验证后置条件。
陷阱 4:重试上限过高。十次重试会增加分钟的延迟。对于面向用户的操作,3 次尝试就足够了。更高的限制属于后台作业。
陷阱 5:缺少半开转换。没有探测请求,熔断器在短暂故障后会永久保持打开状态。
陷阱 6:仅记录调试级别日志。结构化记录每次重试——尝试次数、错误类型、耗时和幂等密钥。将日志结构化为 JSON 以供机器解析。
常见问题
问:多少次重试尝试是合适的?
答:三到五次是标准做法。面向用户的操作应使用 3 次;后台批量处理可以容忍 5–10 次。始终配合最大延迟上限。
问:当 LLM 返回错误时应重试吗?
答:传输层错误(超时、503)应在编排层重试。输出格式错误应作为结构化反馈返回给模型以进行自我纠正。
问:降级和重试有什么区别?
答:重试是重复相同的操作。降级是执行不同的操作以达到相同目标。重试应对临时故障;降级应对持久故障。两者都是必要的。
问:幂等密钥会与合法重复冲突吗?
答:是的,如果两个不同的用户发起了相同操作。始终将密钥限定范围,包含唯一用户或会话标识符。
问:如何测试错误处理?
答:使用混沌工程引入受控故障。模拟上游服务返回特定错误码。验证重试、降级和熔断器按预期激活。单独和组合测试每种故障模式。
结论
适用于生产环境的 AI Agent 将错误处理作为首要架构考量。本文介绍的这些模式——错误分类、带抖动的有界指数退避、幂等密钥、验证后重试、降级链、熔断器和模型感知的恢复——构成了分层防御,确保在单个组件故障时 Agent 仍能运行。
从错误分类开始。为临时错误添加有界重试。为有副作用的操作引入幂等密钥。为模糊结果实现验证后重试。设计降级链并部署熔断器。为基础设施韧性无法修复的推理错误构建模型级恢复。
在生产环境中存活下来的 Agent 不是最聪明的,而是那些优雅失败、系统恢复、即使在个别组件故障时仍能持续交付价值的 Agent。
—
准备构建有弹性的 AI Agent 了吗?请访问 SmaugBrain 探索生产级 Agent 工作流、错误处理模板和部署指南。